用 Claude 做 Graph Engineering:它是什么,以及怎么真正用起来
Graph Engineering with Claude. What It Is and How to Actually Use It 原文发布于

几周前,整个 AI 圈子都在谈循环(loop)。然后图(graph)出现在了每个人的时间线上,循环一夜之间成了旧闻。
转变发生得很快。但关于 Graph Engineering(图工程)的大多数帖子,要么空泛得没什么用,要么技术得根本跟不上。没有人先解释清楚图到底是什么,就开始教你去搭一个。
读完这篇文章,你会知道图到底是什么,以及如何辨认出藏在你当前工作流里的那一张。 还有让图变得强大的那一个模式、它们会在哪里悄悄失效,以及如何用 Claude 在几分钟内亲手搭出一个。
图到底是什么
大多数人听到“图”,想到的是带柱子或折线的图表。这里说的不是那个。在 AI 工作的语境里,图比听起来更简单:它是一张地图,标出哪些工作需要完成,以及每项工作依赖什么。
整件事由两样东西组成。
节点(node)是一个工作单元。一个 Agent,一项任务,一个输入,一个输出。不是“研究这个主题的一切,然后写总结,顺便再核对来源”,而只是其中的一件。工作越小、定义越清楚,节点就越有用。
边(edge)是一条依赖。当第二个节点真的需要第一个节点的产出时,边把它们连起来。不是“这两件事按先后发生”,而是只有当一个的输出确实喂给另一个的输入时才算。
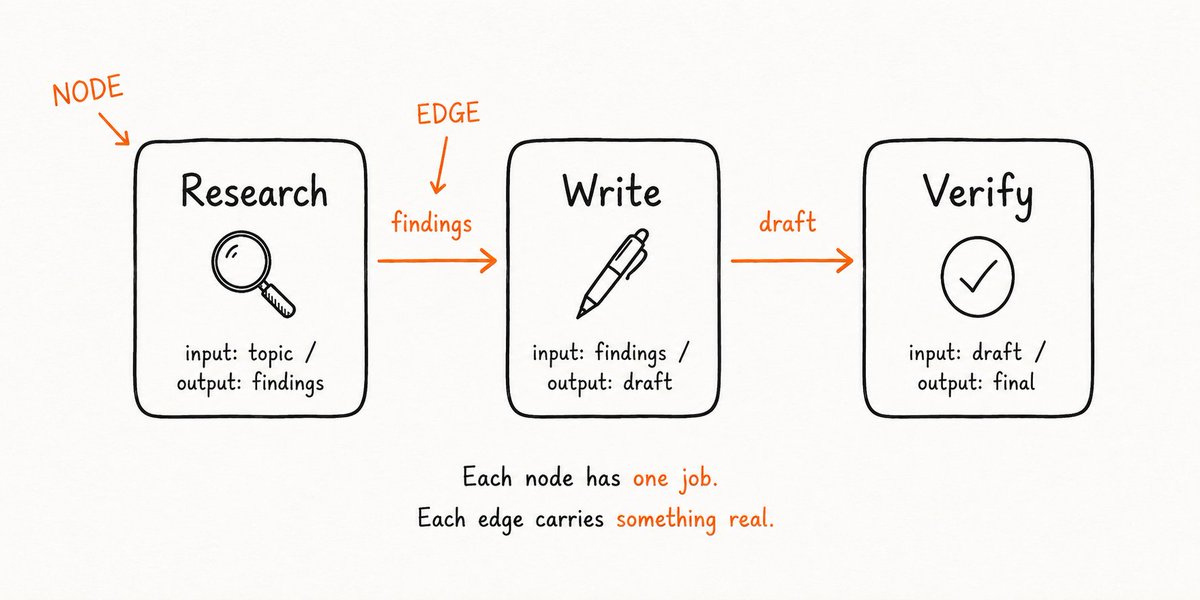
就是这样。节点干活,边传递它们之间流动的东西。Graph Engineering 里的其他一切,都只是把这两个概念用在不同的尺度上。
你当前的工作流已经是一张图
大多数人第一次听说 Graph Engineering 时都漏掉了这一点:你已经在做了。只是做得很差。
当你写下“研究这个主题,然后总结你的发现,然后根据总结写一份草稿”这样的 prompt 时,那就是一张图。一条没有分支的链,每一步都等前一步完成。一个头,一条线,一次一件事。
它能正确运行。但它跑得慢,也容易坏。如果总结那一步产出的东西没法用,写草稿那一步就失败了。如果研究那一步耗时太久,后面的一切都在等。链没有冗余,也没有弹性。它是最简单的图,而简单不等于高效。
Graph Engineering 的第一步不是学新东西,而是看看你已有的东西,然后问:每一步真的都需要等前一步吗?因为大多数时候,并不需要。
❌ 线性链:
研究 → 总结 → 写作 → 核对来源 → 排版 → 发布
六步排成一列。每一步都在等。总耗时:六步之和。
✅ 重画成图:
研究 + 核对来源(同时进行)→ 总结 → 写作 + 排版(同时进行)→ 发布
同样的工作。更少的等待。因为互相独立的工作不再排在彼此后面,所以完成得更快。
假边测试
一旦你能把工作流看成一张图,下一步就是找出那些本不该存在的边。
一步一步看你当前的工作流。在每个箭头处问一个问题:这一步真的需要上一步的结果吗?不是“它是不是排在后面”,而是它是否真的用到了上一步的产出?
如果是,这条边是真的。保持顺序。
如果不是,那就没有边。这两项工作彼此无关,它们之间的等待纯属浪费。
举个简单的例子:“审查文件 A 的 bug,然后审查文件 B 的 bug。”读起来像一个序列。但对文件 B 的审查从不看文件 A 返回了什么。它们一前一后地跑,只是因为你是按这个顺序敲的。让它们同时跑,整件事在较慢那一个的时间内就完成了,而不是两者相加。
不到五分钟就能对任何工作流跑一遍这个测试:
- 把每一步写成一个方框
- 在每对相邻步骤之间画一个箭头
- 对每个箭头问:步骤 A 的数据真的进入了步骤 B 吗?
- 是,保留箭头。这是真依赖
- 否,删掉箭头。这是一条假边
- 没有入边的都可以立即开始
- 没有出边的都是最终输出
几乎在你画出的任何工作流里,你都能找到两三条假边。每一条都是你白白送出去的时间。
菱形
一旦你开始删除假边,有一个模式会比其他任何模式都更频繁地出现。它叫菱形(diamond),正是它让图值得一用。
想法很简单。一个节点 fan out(扇出)成几个并行节点。这些并行节点全部汇入一个最终节点,由它把各自的输出收拢到一起。画出来,它就像一个菱形。

在实践中它长这样。假设你在为一篇文章做主题研究。线性版本是:搜索 → 读来源 1 → 读来源 2 → 读来源 3 → 综合。
菱形版本:搜索 → [并行读来源 1 + 来源 2 + 来源 3] → 综合。
最终的综合节点在两种方式下拿到的输入是一样的。但它等待的时间只是最慢那一次来源阅读的长度,而不是三者相加。
菱形之所以成立,是因为综合确实依赖全部三次阅读。这些是真边。但三次阅读之间彼此没有依赖。那些连接并不存在。所以你让它们同时跑,唯一的等待发生在最后,而那里的等待反正是免不了的。
这就是为什么一旦你开始留意,菱形就会无处不在。研究流水线。代码审查。市场分析。只要你的工作里有“从多个地方收集,然后合并”的形状,你就有一个菱形。收集是并行的。合并是汇聚点。
这个模式有两条规则。第一,并行节点必须真正独立,不能有伪装成真边的假边。第二,汇聚节点必须真的需要它们全部。如果它只需要其中一个,其他的就是白干。
把这两点都做对,菱形就是一个工作流所能采取的最快形状。
图会在哪里悄悄失效
菱形在理论上很干净。实践中它会在两个具体的地方出问题,而且两个都容易被忽略。
第一个是坏节点未被发现。三个来源并行运行,其中一个返回了垃圾:一个幻觉、一个空结果、一个读错的文件。这个坏输出会和另外两个好输出一起,直接流进你的综合节点。
综合节点并不知道它的某个输入是错的。它把所有东西合在一起,产出一个建立在坏材料上的、自信满满的答案。让事情变快的并行结构,同时也移除了那些你本来会注意到问题的天然检查点。
第二个是级联。在线性链里,一个坏步骤产出一个坏输出,你立刻就能看到。在有汇聚路径的图里,坏输出会和好输出混在一起,错误变得更难追踪。等到最终节点给出响应时,损害已经被稀释,看不见了。
两个问题的解法相同:一个检查节点(checker node)。
检查节点位于你的并行层和汇聚点之间。它唯一的工作是在每个输出往前传之前评估它。它不综合、不写作、不做任何主体工作。它只问:这个输出能用吗?能,就放行。不能,就标记、重试或丢弃,赶在它毒害下一步之前。
检查节点应该抓住的五件事:
- 空输出或 null 输出:一个没返回任何有用东西的节点
- 互相矛盾、不可能同时为真的输出
- 相对于原始任务跑题的输出
- 低到不可靠的置信度信号
- 会让综合节点解析失败的格式错误
没有检查节点的图,就是一张假设上游一切正常的图。这个假设失效的频率比你想的高。
静态图 vs. 动态图
到目前为止,一切都假设你在开始之前就知道图的形状。你定义节点,画出边,然后运行。对于结构不变的可重复工作流,这行得通。
但很多真实工作不符合这个形状。你开始一项研究任务,做到一半发现某个来源还需要另外三次查询。你开始一次代码审查,发现某个文件需要比其他文件更深入的分析。你需要的结构在开始时是不可知的,只有当工作展开后才变得清晰。
这就是动态图的用武之地。它不是预先定义好的固定结构,而是在运行过程中自己构建自己。一个节点完成工作,看看自己发现了什么,然后决定接下来应该有哪些节点。这张图不是规划出来的,而是长出来的。
这个区别在实践中很重要。静态图快而可预测。你确切知道什么会运行、按什么顺序、大概要多久。动态图灵活,能应对意外。但出了问题更难调试,因为实际运行的结构不是你最初画的那一张。
在开始前弄清楚你需要哪一种,能省下大量回头路:
- 用静态图,当任务可重复、结构每次都一样
- 用静态图,当速度和可预测性比灵活性更重要
- 用动态图,当工作范围取决于你一路上的发现
- 用动态图,当某些节点需要根据自己的输出决定下一步
- 永远先用静态图,只有当静态版本撞上它处理不了的墙时才切换到动态
- 绝不用动态图做任何你需要精确审计“到底运行了什么、为什么”的事情
大多数看起来需要动态图的工作流,其实只是需要一张设计得更好的静态图。动态版本更强大,也更难控制。把它放在第二位,而不是第一位。
差别实际上是什么样
理论在抽象层面容易理解。下面是同一个任务用两种方式跑的样子,你可以看到究竟什么变了。
任务:分析三个竞品并写一份对比。
不用图:
研究竞品 A → 研究竞品 B → 研究竞品 C → 三者对比 → 写草稿 → 核对事实 → 排版输出
七步,全部串行。总耗时是每一步之和。如果第二步比预期更久,后面的一切都在等。
用图:
[研究 A + 研究 B + 研究 C] → 检查节点 → 对比 → [写草稿 + 排版输出] → 最终检查
五个逻辑阶段。三个研究步骤同时跑。写作和排版同时跑。检查节点在坏的研究结果到达对比之前就把它拦下。总耗时大幅坍缩。
输出相同。结构不同。
下面是两种方式各自的胜负所在:
| 线性 | 图 | |
|---|---|---|
| 搭建时间 | 低 | 较高 |
| 总运行时间 | 慢 | 快 |
| 易于调试 | 是 | 较难 |
| 处理运行中的错误 | 差 | 好(检查节点) |
| 适合一次性任务 | 是 | 杀鸡用牛刀 |
| 适合可重复工作流 | 是 | 更好 |
| 随任务增长而扩展 | 否 | 是 |
这张表看起来像是除了搭建和调试之外,图处处都赢。对于任何你要跑不止一次的事情,这大致是对的。对于永远不会重复的一次性任务,线性版本几乎总是更快搭好、更快跑完。
当任务大到时间节省会累积,或者中途的错误昂贵到检查节点能收回成本时,图才值得。
如何用 Claude 搭一个
上面这些在你给 Claude 一个它能执行的东西之前,都还只是一个心智模型。从这里开始,它变得可操作。
Claude Code 有一个 workflow 关键字,它会改变 Claude 处理你指令的方式。没有它,Claude 把你的 prompt 当作一个序列来读,一步接一步地执行。有了它,Claude 会解析结构,识别出哪些节点彼此没有依赖,并自动并行运行它们。你描述图,Claude 推算执行顺序。
一个基本的 workflow 长这样:
workflow: research-and-compare

nodes:
  research_a:
    task: "Research competitor A's pricing, features, and recent news"
    output: competitor_a.md

  research_b:
    task: "Research competitor B's pricing, features, and recent news"
    output: competitor_b.md

  research_c:
    task: "Research competitor C's pricing, features, and recent news"
    output: competitor_c.md

  checker:
    task: "Review each research file. Flag any that are incomplete or off-topic."
    depends_on: [research_a, research_b, research_c]
    output: checker_report.md

  compare:
    task: "Using the research files, write a structured comparison across price, features, and positioning."
    depends_on: [checker]
    output: comparison.md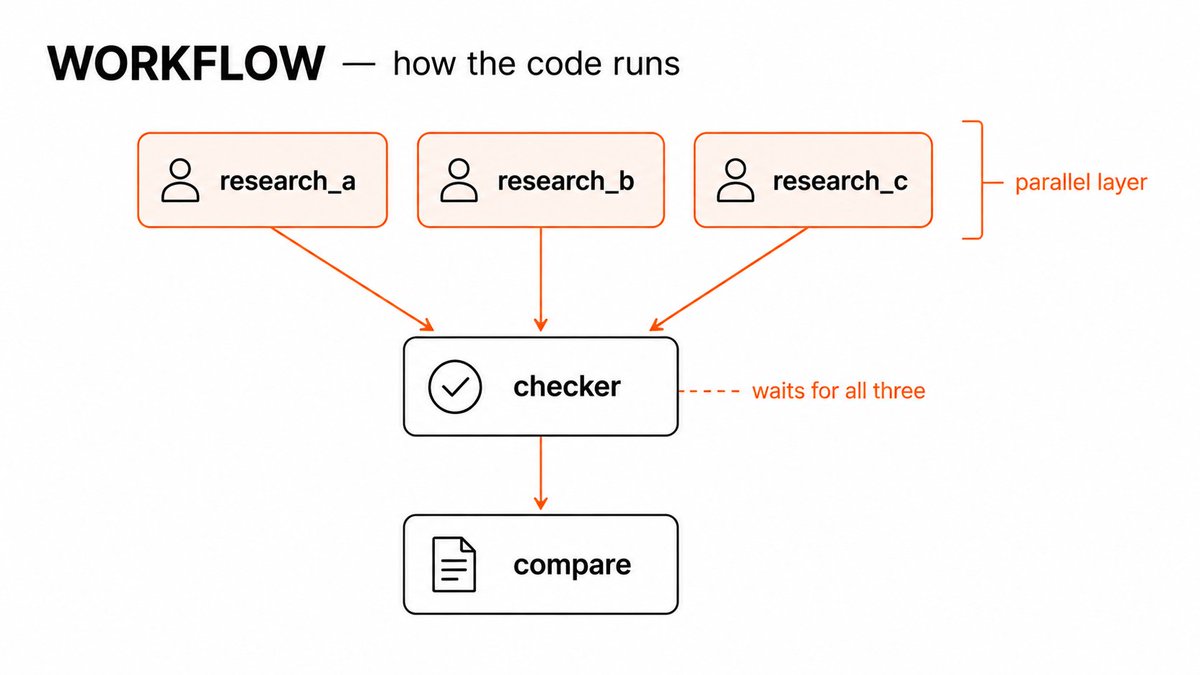
有三点值得注意。第一,research_a、research_b 和 research_c 没有 depends_on,workflow 一启动,Claude 就同时运行这三个。第二,checker 把这三个都列为依赖,所以它会等到三个全部完成才运行。第三,compare 只依赖 checker,而不直接依赖研究节点,检查节点就是把关者。
那一行 depends_on 是你设计任何图唯一需要理解的东西。没有依赖就意味着并行。有依赖就意味着等待。其他一切只是决定哪些节点需要什么。
可以直接粘贴的 prompt
上一节的 workflow 语法适用于任何可重复的任务。这里有四个你可以直接丢进 Claude Code 再自行调整的例子。
竞品研究:
workflow: competitive-research

nodes:
  research_a:
    task: "Research [Company A]. Cover: pricing, core features, recent product changes, public sentiment. Output a structured summary."
    output: company_a.md

  research_b:
    task: "Research [Company B]. Cover: pricing, core features, recent product changes, public sentiment. Output a structured summary."
    output: company_b.md

  research_c:
    task: "Research [Company C]. Cover: pricing, core features, recent product changes, public sentiment. Output a structured summary."
    output: company_c.md

  synthesize:
    task: "Using company_a.md, company_b.md, company_c.md — write a comparison table and a one-paragraph positioning summary for each."
    depends_on: [research_a, research_b, research_c]
    output: comparison.md
多文件代码审查:
workflow: code-review

nodes:
  review_auth:
    task: "Review auth.py for security issues, edge cases, and code quality. Be specific."
    output: review_auth.md

  review_api:
    task: "Review api.py for security issues, edge cases, and code quality. Be specific."
    output: review_api.md

  review_db:
    task: "Review db.py for security issues, edge cases, and code quality. Be specific."
    output: review_db.md

  checker:
    task: "Read all three review files. Flag any issues that appear in more than one file. Note cross-file dependencies that could cause problems."
    depends_on: [review_auth, review_api, review_db]
    output: checker.md

  summary:
    task: "Using all review files and checker.md, write a prioritized list of fixes — critical first, then medium, then low."
    depends_on: [checker]
    output: final_review.md
文章研究与草稿:
workflow: article-research

nodes:
  angle_a:
    task: "Research [topic] from the angle of [audience A]. What do they care about most? What are the common misconceptions?"
    output: angle_a.md

  angle_b:
    task: "Research [topic] from the angle of [audience B]. What do they care about most? What are the common misconceptions?"
    output: angle_b.md

  examples:
    task: "Find 3 specific real-world examples of [topic] that most people haven't heard of. No generic case studies."
    output: examples.md

  draft:
    task: "Using angle_a.md, angle_b.md, and examples.md — write a draft that speaks to both audiences and opens with one of the specific examples."
    depends_on: [angle_a, angle_b, examples]
    output: draft.md
把方括号里的内容替换掉。不管你在节点里放什么,结构都保持不变。
当你用图来思考时,什么会改变
前两节里的 workflow 立刻就能用。但更大的转变发生在你用了几周之后。
你不再把一个任务读成一份待办清单,而是读成一组依赖关系。第一个问题不再是“我先做什么?”,而是“到底什么需要等什么?”。大多数时候答案是:比你以为的少。
这种变化也体现在你写 prompt 的方式上。线性 prompt 告诉 Claude 按顺序做什么。图式 prompt 告诉 Claude 每一块需要什么,然后让它自己推算顺序。这样的 prompt 更小、更容易修改,而且当你换掉某个节点时也不会坏。
对于任何你跑过两次以上的 workflow,最后值得加上的一样东西是一条 CLAUDE.md 条目。它告诉 Claude 你希望在这个项目里如何处理图:你对输出格式、检查节点行为和错误处理的默认设定,这样你就不用每个会话都重建这些上下文:
# Workflow defaults

When running a workflow:
- All nodes without depends_on run in parallel by default
- Checker nodes should flag incomplete outputs, not silently pass them
- Output files go to /outputs with the node name as filename
- If a node fails, pause and report before continuing
- Never merge outputs from flagged nodes into the final synthesis
一个文件,设置一次。你在那个项目里运行的每个 workflow 都会继承它。
你现在画的图,六个月后看起来会显得理所当然。不是因为它们容易,而是因为一旦你清楚地看见了依赖关系,就再也无法视而不见。任何工作流的线性版本,都会开始露出它的本来面目:一张所有边都是假的图。
在文章开头我说过,关于 Graph Engineering 的大多数帖子要么太空泛,要么太技术。我是认真的,而我试着在两者之间走出一条路。
你现在知道了图是什么。你知道如何找出藏在你当前工作流里的那一张。你知道假边测试、菱形、检查节点,以及什么时候该用动态图而不是静态图。你有了在 Claude Code 里搭建它的语法,还有四个今天就能用的 prompt。
这就是全部。在这些东西变得有用之前,你不需要更深一层的图论。
如果有人让我别写某一项,我唯一会坚持保留的是:假边测试。这周对一个工作流跑一遍。只要一个。画出步骤,逐个检查箭头,问哪些真的在传递数据。你至少会找到一条不是的。
那就是整个模型豁然开朗的时刻。不是在你理解理论的时候,而是在你从自己搭的东西里找到第一条假边、并意识到你已经为它白等了几个月的时候。
其余的都从那里开始。