Graph Engineering 详解:它是什么、何时该用、何时不该用
Graph Engineering explained: what it is, when to use it and when not to 原文发布于
大多数人只用到了 AI 真实能力的 5% 到 10%。有一条更快的路,而且它比看上去更大。学会它,你能优化的就不只是个人任务,而是庞大的流程。
这正是大公司里一些真实岗位背后的技能。它是“做好一份工作”与“设计一百份工作如何被完成”之间的差别。
我很早就幸运地接触到了它。我在丹麦最好的大学之一念书时,有一整门课只讲一件事:如何把一个流程画成图,并把它做到尽可能高效。
当时它显得很抽象。现在,它恰恰就是你时间线上顶尖 AI 工程师们争论的东西。
读完这篇文章,你对 Graph Engineering(图工程)的理解会超过你关注的几乎所有人: 图到底是什么、那个能立刻让你的 AI 变快的测试、唯一一个值回票价的模式、这些东西会在哪里悄悄崩掉、什么时候图是错误的工具,以及如何在几分钟内亲手搭一个真正的图。
在进入正题之前,欢迎在 X 上关注我,并加入我刚创建的 Telegram 频道,我每天都会在那里发布更多 AI 内容。两者都是免费的。
X - https://x.com/AnatoliKopadze
Telegram - https://t.me/kopadzemp
我们还在聊循环(loops),还是已经转向图(graphs)了?
— Peter Steinberger (@steipete),2026 年 7 月 18 日
1 - 这东西到底从哪来的
一个月前,整个圈子都在谈循环。然后 Peter Steinberger 发了上面那条帖子,互联网的某个角落——刚学会循环的那群人——一夜之间宣布循环过时了。
这个玩笑之所以好笑,是因为它有一半是真的。如果你读过我那篇关于循环(Loops)的文章,你已经有了基础。一个循环就是一个 Agent 反复改进一件事:尝试、检查、调整、再来一遍。那是上个月的技能。
大家转向的并不是一种更好的循环,而是一张由循环组成的图:一个网络,其中各个循环互相监督、互相纠正,而不是一个 Agent 孤零零地追着一个数字跑。
而工程师们在几小时内就对这波炒作提出了反驳,指出这是一个几十年前的老想法换了个新名字。他们说得对,而这正是好消息。一个在关键系统里跑了三十年的模式,恰恰是你愿意把工作托付给它的那种。
2 - 图到底是什么
图(graph)不过是你 AI 工作的一份计划,只是画出来让你看得见。它回答两个问题:哪些工作需要完成,以及哪项工作必须等哪项。
它只有两个组成部分,把它们弄清楚,大部分困惑就消失了。
一个方框叫做节点(node)。它就是一项工作:一个 Agent 做一件任务,有一个输入、一个输出。调研一个竞品。写一份草稿。核实一个说法。
一个箭头叫做边(edge)。它只表示一项工作需要另一项工作产出的东西,所以必须等它。而且只有当真的有东西沿着箭头传递时,这条边才算数。

节点负责思考。边负责传递结果。这就是全部词汇。掌握了它,你再也不需要别的定义。
让一个节点在图里真正可用的,是一份契约(contract):一项有边界的工作、一个明确的输入、一个明确的输出。输出是一大段自由文本的节点,只有人类能读。输出形状固定的节点,下一个节点才能不用猜就直接消费,而这正是全部的意义所在。
▸ NODE CONTRACT
JOB:     research one competitor's pricing (one job, nothing else)
IN:      { competitor: "name", url: "https://..." }   ← passed in, never assumed
OUT:     { price: number, plan: string, source: url, date: "YYYY-MM-DD" }
SCHEMA:  enforced. if the agent returns free text, it's rejected and retried
WHY:     a defined output is what lets the next node read this one
         without a human in the middle. that is what makes it wire-able.
3 - 找出假边的测试
看看你今天在跑的 AI 工作流,一步一步过一遍。在每一步问一个问题:这一步真的需要上一步的结果吗?
如果需要,这条边是真的,保持顺序。如果不需要,那就没有边,等待就是浪费。这两项工作可以同时跑。
举个简单的例子:“审查文件 A 的 bug,然后审查文件 B 的 bug。”它读起来像一个序列,但对文件 B 的检查从不看文件 A 返回了什么。它们一前一后地跑,只是因为你是按这个顺序敲的。让它们并排跑,整件事在较慢的那一个文件的时间内就完成了,而不是两者相加。
几乎在你画出的任何工作流里,你都能找到两三条这样的假边。每一条都是你在白白扔掉的时间。

4 - 你现在的设置已经是一张图了
当你把一个 Agent 写成“做 A,然后 B,然后 C,然后 D”时,技术上你已经画了一张图。只不过是最可怜的那种:一条笔直的链,每个节点一个箭头进、一个箭头出。
它能正确运行。但它也跑得慢、容易坏,因为链没有冗余。如果 C 卡住了,D 就永远不会发生,而 A 的成果被困在上游,无处可去。
Graph Engineering 的第一项真正技能就是重画这条链。拿起你的线性工作流,对每一个箭头问那个假边问题。砍掉不承载数据的箭头,这条线就会坍缩成更宽的东西:几项可以同时跑的独立工作,喂给一项需要它们全部的工作。
这件事重要的原因不是美观。一个 40 步的线性工作流有 40 个串行故障点,延迟是 40 步相加。同样 40 项工作画成图,只有实际存在的那几条真依赖(通常三到五条),完成速度取决于你最慢的那一层,而不是所有东西的总和。做完全相同的工作,这就是五分钟和十五秒的区别。
模型从来不是瓶颈。你画的那条线才是。
5 - 唯一值回票价的模式:菱形
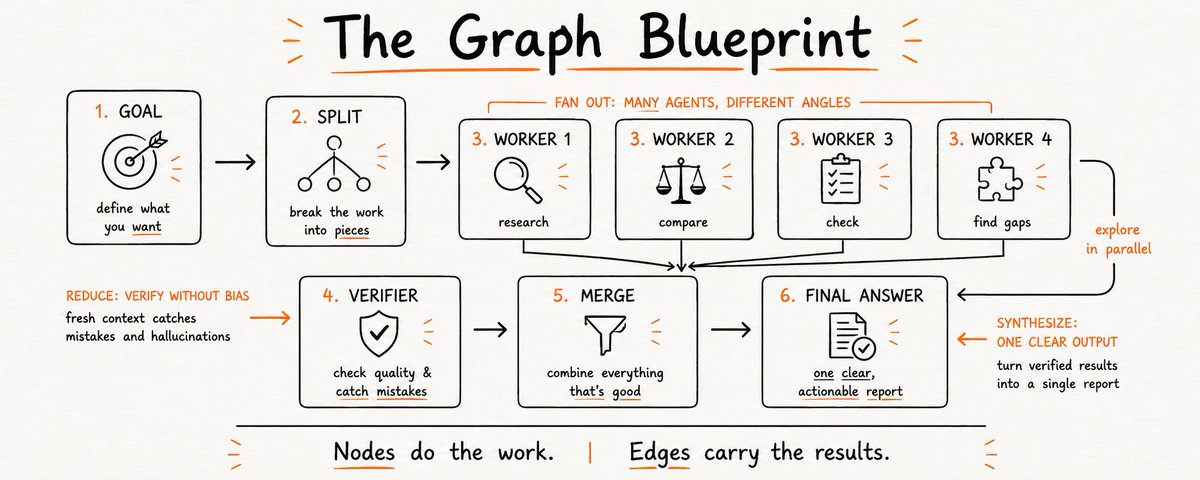
你不需要一百种形状。观察任何一个严肃的 Agent 系统工作,同一幅画面会反复出现。工作被拆开,几个 worker 并排挖掘,某个东西检查它们的发现,然后一切合并回一个答案。
这幅画面叫做菱形(diamond),它几乎是你今年唯一需要的模式。它的正式名称值得记住:fan out、reduce、synthesize(扇出、归约、综合)。
用 fan out 获取广度,用普通代码做 reduce 来压缩,用最后一个 Agent 做 synthesize 写出答案。

Claude 内置的 research 功能在生产环境里跑的正是这个。一个 lead Agent 规划调研角度,worker 们并行收集,发现被检查,然后一份报告才到你手上。一旦你能看见这个菱形,你就不再问“我怎么让我的 Agent 多做几步”,而是开始问“拆分在哪里,合并在哪里”。第二个问题才是能规模化的那个。
下面是菱形在引擎盖下的真实样子。当你说 “workflow” 时,Claude 会自己写一段这样的短脚本,把协调当作代码来跑,这就是为什么在 Agent 之间传递结果不额外消耗任何上下文。
// a market-scan graph — the diamond, written by Claude when you say "workflow"

const angles = [
  "pricing vs the top 3 competitors",
  "what buyers complain about in reviews",
  "the feature gaps in the category",
  "where the market moves in the next 12 months",
];

// FAN OUT — one researcher per angle, all at the same time
const raw = await parallel(
  angles.map(a => () => agent({
    task: `research: ${a}. every claim needs a source url + date.`,
    schema: Finding,        // validated output, not free text
    model: "cheap",         // boring node → cheap model
  }))
);

// REDUCE — plain code, no model, no tokens
const findings = dedupeBySource(raw.flat().filter(Boolean));

// VERIFY — a FRESH skeptic per finding, tries to kill it
const survivors = await parallel(
  findings.map(f => () => agent({
    task: "try to disprove this. return keep | drop + why.",
    input: f,
    freshContext: true,     // never reuse the researcher's chat
    model: "strong",        // judgment node → strong model
  }))
).then(v => findings.filter((_, i) => v[i].verdict === "keep"));

// SYNTHESIZE — one agent writes the answer from what survived
return agent({ task: "one report, ranked by confidence, sources attached.",
               input: survivors, model: "strong" });
读一遍,整套手艺就一目了然:在工作彼此独立的地方 fan out,用免费的代码做 reduce,在全新上下文上做 verify,无聊的节点用便宜模型、需要判断的地方用强模型,最后做一次 synthesize。市场扫描、代码审查或研究报告,背后都是同一副骨架。换掉角度和 prompt 就行。
6 - 检查器才是全部的诀窍
现在说说几乎所有人都跳过的部分,它正是真正的图与昂贵玩具之间的分界线。
每一项关于 AI 自我审查的严肃测试都说同一件事:模型会漏掉自己的大部分错误。一个给自己打分的模型,对自己太宽容了。
所以,你永远不要让干活的那个 Agent 去检查活。
你在边上放一个独立的节点。它唯一的工作就是在结果往下传之前,尝试干掉它。挺过去了就通过,挺不过就死在那里。
这里有一个没人点明的关键:那个检查器需要一个干净的上下文。
把 worker 用过的同一段对话交给它,它检查的就不是任何东西,只是换了一种字体在对自己点头。一群共享一个上下文的 Agent 组成的图,只是一个穿了戏服的单循环,它会以同样的方式崩掉,只是更晚、更贵。
所以,让验证器(verifier)保持全新。拥有自己的上下文。检查的是真实信号:不是“Agent 说它做完了”,而是“测试真的通过了吗”。
然后把检查拆成三路。它正确吗?它是最新的吗?来源到底存不存在?三个不同的视角,能抓住十个相同视角漏掉的东西。
▸ VERIFIER NODE
INPUT:    one finding from a worker (the finding only, never the worker's chat)
CONTEXT:  fresh and empty. it has not seen the work it is judging
CHECKS:   three skeptics run in parallel, each with a different question
  1. is it correct?      → does the claim actually hold up
  2. is it current?      → is the source recent, not something stale
  3. is the source real? → does the link resolve to the claim it's cited for
PASS:     keep the finding only if a majority of skeptics let it live
FAIL:     drop it before it ever reaches the final answer
要记住的规则:worker 和它的验证器绝不能共享上下文。一旦共享,你就回到了一个循环给自己的作业打分,只是账单更大。
7 - 图真正会在哪里崩
1. 上下文坍塌。
fan out 一千个节点,然后试图把一千个输出全塞进最后一步,还没开始综合,你就已经撑爆了上下文窗口。
解法:分层 fan-in(扇入)。把结果分批,每批各自总结,然后合并总结,而不是原始的一大堆。
// layered fan-in — never pour 1,000 raw outputs into one step
const batches = chunk(results, 40);              // groups of 40
const summaries = await parallel(
  batches.map(b => () => agent({ task: "summarize this batch", input: b }))
);
return agent({ task: "write the answer from the summaries", input: summaries });
// the final step reads ~25 summaries, not 1,000 raw outputs
2. 假独立。
两个节点看起来独立,因为它们的 prompt 从不提及对方,但它们都写同一个文件,或者都打同一个有速率限制的 API。这是一条隐藏的边。
Bun 团队第一次把一个大任务 fan out 到许多 Agent 时,它们共用一个工作区,互相覆盖了对方。
解法:给每个 worker 自己的隔离空间,并审计共享的资源,而不只是共享的数据。
// isolate the workers — no shared file, no shared workspace
await parallel(files.map(f => () => agent({
  task: `refactor ${f}`,
  worktree: true,        // each agent works in its own git worktree
})));
// they can't overwrite each other, then the results merge cleanly
// rule: any two nodes writing the same file need an edge, not parallelism
3. 节点静默失败。
在链里,一个失败会停掉一切,烦人但显眼。在图里,两百个节点中一个死掉的节点,可以悄悄溜进一份看起来完整的报告。
解法:每个合并步骤都把收到的输入数量和预期数量对一下,发现缺口就标出来,而不是拿着一半的数据默默往下跑。
// fan-in guard — catch the node that quietly died
const results = (await parallel(jobs)).filter(Boolean);   // dropped nodes = null
if (results.length < jobs.length) {
  flag(`WARNING: ${jobs.length - results.length} of ${jobs.length} nodes returned nothing`);
}
// never synthesize on a partial set and call the report complete
8 - 你到底需不需要一张图?
按照我文章的惯例,让我们诚实地弄清楚这东西究竟对谁有用。
图买来的是广度,买不来更好的判断力。
它是一种关于宽度的工具,用于同时完成彼此独立的工作。当工作不宽时,那条线从来就不是问题。
以下情况别用图:
-
任务很小或很孤立。加一个函数,修一个 bug。协调纯属开销,一个 Agent 更快也更便宜。
-
你想审批每一步。图的全部意义就是在没有你的情况下铺开跑,紧紧攥着缰绳跟它是对着干的。
-
你还不知道自己在找什么。探索性的工作需要一个你能随时掌舵的 Agent,而不是一队被锁进计划里的 Agent。
-
各步骤真的互相依赖。把图硬套在真正串行的工作上,只会增加成本,零加速。
-
判断标志就是假边测试。如果你找不出两项之间没有边的工作,那就没有图可建。它是一个循环,而循环没什么不好。
9 - 没人想听的部分:锚点
这里有一个更深的陷阱,它才是整个转变的真正教训。
想象你搭好了完整的图。成对的检查器、审计节点、调优其他节点的元节点。每个节点都盯着另一个节点,而每一个都在读一份报告。
审计节点拿数字去对照财务数字,可财务数字一开始就来自同一个系统。
一切都自洽。没有任何东西被验证。
这张图会像那个单循环一样失败,只是更晚、更贵,而且在坠落的路上亮着多得多的绿灯。

拓扑本身买不来真相。图需要锚点(anchor):无法争辩的节点。
真正跑过的测试,不是“应该能过”,而是确实过了。真正进了银行账户的收入。真正留下来的客户。
还有一些规则必须冻结,就是那些优化器会忍不住去削弱的规则。恰恰因为它们是它为了赢会去弯折的那些,所以要设成禁区。
图的诚实程度,只取决于它内部那些拒绝移动的东西。
用无法反驳的数字来评判它,它就保持脚踏实地。让它给自己的报告打分,它就会自信地错下去。
10 - 在 Claude Code 里亲手搭一个
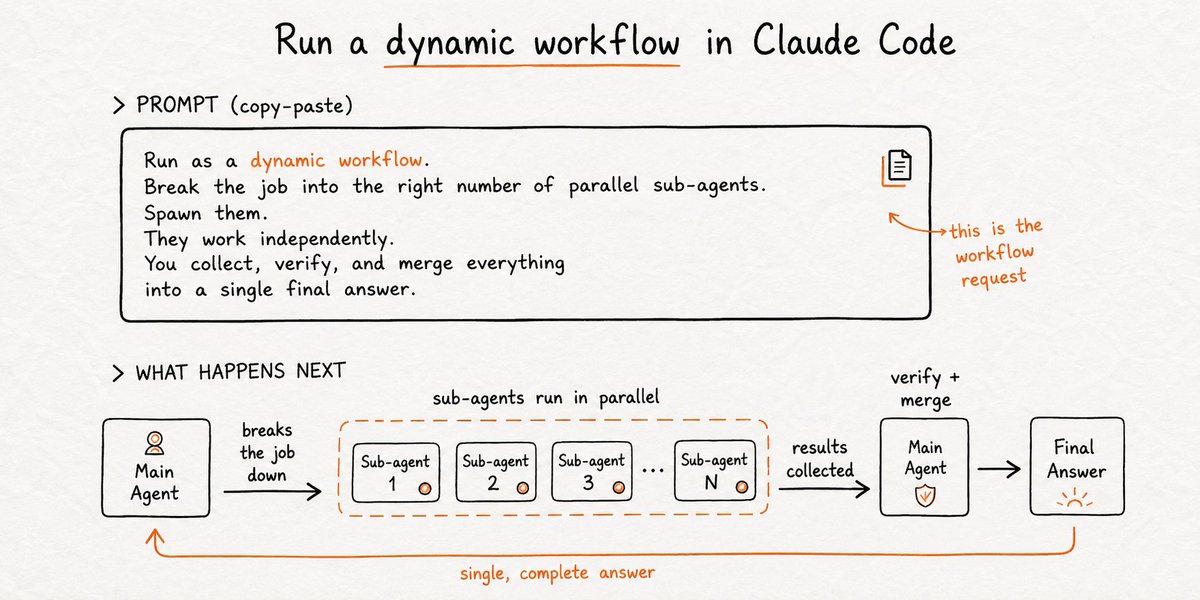
理论够了。如果你已经决定这适合你,或者只是想试试,我们来搭一个。你可以在几分钟内搭出一张真正的图,因为 Claude Code 已经直接发布了做这件事的工具,叫做 dynamic workflows(动态工作流)。
归结起来就是一个词:“workflow”。
把它放进你的 prompt,Claude 就不再沿着一条单线一步步走,而是先写一段简短的编排脚本,然后 spawn 一队协同工作的 subagent 去执行它。
重要的是,协调是代码,不是对话。在 Agent 之间传递结果,不会像聊天交接那样再次消耗你的上下文,这正是让一次运行能扩展到一整队 Agent 而不淹没你的会话的原因。
打开一个你熟悉的真实仓库,粘贴这个:
▸ GRAPH SPEC
GOAL: audit every route file under src/routes/ for missing auth checks

FAN OUT:    one agent per file, all running in parallel
VERIFY:     an independent checker on each finding, with fresh context
CAP:        20 files on this first run
ON FAIL:    flag any file that doesn't return, never skip it silently
REPORT:     one merged list of the routes missing auth

(start the prompt with the word "workflow" so Claude builds the graph)
运行它,接下来会发生这些事。
首先,Claude 会提示它正在构建一个 workflow 而不是在普通聊天里作答,并在动手之前把计划展示给你。你读完,批准。
然后这队 Agent 开跑。一个文件一个 Agent,全部同时进行,而你自己的会话全程保持空闲。
最后落到你手上的,不是二十段需要翻找的独立对话,而是一份报告。中间结果都活在脚本里,从未进入你的上下文,所以你真正看到的只有最终答案。
这就是一张图。一句话,一打 Agent。当某次运行效果不错时,把它保存下来,它就变成一条你可以永远按名字重跑的命令。
注意那个 prompt 里的 “20 files” 上限。它让你的第一次运行保持便宜,也暗示了每个 demo 都略去的那件事:账单。
11 - 可以直接粘贴的现成图
下面每一个都是同一个菱形,只是对准了不同的工作。在一个真实的文件夹里打开 Claude Code,把方括号里的部分换成你自己的,然后粘贴。“workflow” 这个词就是告诉 Claude 去构建一队协同的 Agent,而不是一条单线步骤。在任何东西上线之前,把自己留作最后一道“同意”。
一个决策级的研究台。 替代一周的谷歌搜索或一张昂贵的分析师账单。你的问题被拆成多个角度,研究员同时挖掘,一个怀疑者攻击每一项发现,只有幸存者才进入报告。
▸ GRAPH SPEC
GOAL: decision-grade research on [your question]

FAN OUT:      split into 5 distinct angles, one researcher per angle, in parallel
RULE:         every finding needs a source link and a date
VERIFY:       a skeptic attacks each finding and tries to disprove it, drop what fails
MERGE:        survivors into one report ranked by confidence
SAVE:         research-report.md, then show me the top findings
HUMAN GATE:   change nothing after that without asking me

(start the prompt with the word "workflow" so Claude builds the graph)
一台 SEO 内容机器。 每次运行产出一份可以冲排名的草稿,且绝不在没有你的情况下发布。
▸ GRAPH SPEC
GOAL: one ranking-ready draft for [topic]

PARALLEL JOBS (run at once):
  1. what the current top-ranking pages cover
  2. the real questions people ask about this topic
  3. what those top pages skip
MERGE:        the three into an outline, then write a full draft
VERIFY:       a fact-checker that flags every claim without a source
SAVE:         drafts/ with the flagged claims listed at the top
HUMAN GATE:   never publish anything

(start the prompt with the word "workflow" so Claude builds the graph)
一套 go-to-market 工具包。 一次运行生成完整的发布包,每一件都由你审批。
▸ GRAPH SPEC
GOAL: full launch kit for [product], aimed at [audience]

PARALLEL JOBS (research, run at once):
  1. profile the buyer and the exact words they use
  2. map where these buyers spend time online
  3. collect how competitors pitch them
MERGE:        a one-page positioning doc
HUMAN GATE:   pause and show me the positioning doc before writing
PARALLEL JOBS (writing, from that doc):
  1. landing page copy
  2. a week of launch posts
  3. a set of outreach messages
VERIFY:       a checker compares every asset to the positioning doc, flags anything off
SAVE:         launch-kit/, change nothing after that without asking me

(start the prompt with the word "workflow" so Claude builds the graph)
一次横跨整个仓库的重构扫描。 单个上下文装不下的广度。
▸ GRAPH SPEC
GOAL: find every function over 100 lines and propose a refactor for each

FAN OUT:    one agent per file, in parallel
VERIFY:     an independent checker on each proposed refactor, fresh context
DEDUPE:     proposals against everything already seen
CAP:        50 files on this first run
REPORT:     how many files came back, so nothing fails silently

(start the prompt with the word "workflow" so Claude builds the graph)
一个规模未知的发现循环。 用于那些不身在其中就不知道有多大的工作,比如一次 bug 扫描:找到一个 bug 就会暴露出另外三个。
▸ GRAPH SPEC
GOAL: hunt this repo for [security issues / broken error handling / dead code]

FAN OUT:    run finders in parallel
DEDUPE:     check each new find against everything already seen
VERIFY:     an independent checker on the survivors
LOOP:       keep going until two rounds in a row find nothing new, then stop
CAP:        a hard limit on total agents so it can't run away
REPORT:     final list ranked by severity

(start the prompt with the word "workflow" so Claude builds the graph)
先跑一个小范围的,看看它花了多少钱,再扩大。当某次运行效果好时保存下来,这里的每一个都会变成一条按名字启动的命令。
12 - 成本与监督
一张图比一次普通聊天贵,贵得多。变便宜的是协调,而不是工作本身。Agent 仍然在烧 token,一整队 Agent 烧的是一大堆。
最清楚的例子是公开的。一位工程师用这套完全相同的设置重写了 Bun 运行时,在大约十一天里把约 535,000 行的一种语言翻译成了超过一百万行的另一种语言。手工做,这接近一年的工作量。
它跑了大约 50 个 workflow,同时最多有 64 个 Agent 在工作。
它也花掉了大约 165,000 美元的用量,需要一个人全程设计和盯着,并且在“这么多 AI 写的代码到底能不能被安全地审查”这个问题上招来了真实的批评。
这就是它诚实的样子。一张图可以 fan out 到一千个 Agent,啃下任何单个上下文都装不下的任务。它也可以在后台悄悄花掉你的钱,如果你把它指向了错误的任务,或者跳过了锚点。
所以,重型版本是给有预算、有上限、有监控去跑它的团队准备的。如果你还不是,你也没错过什么。从小处开始,看看一次运行花多少钱,只有当它证明了自己之后再扩大。
13 - 这对你到底意味着什么
这就是全貌。你现在知道了图是什么、它在哪里闪光、在哪里崩溃,以及它到底适合谁。
你知道它的长处:广度,同时完成的独立工作。以及它的短处:它买来的是宽度而不是判断力,而且如果你把它指向错误的工作,它会花掉你的钱。
所以,正确的做法不是把一切都图化,而是知道工作什么时候宽到需要一张图,什么时候一个简单的循环从头到尾就是答案。
我的建议:今晚就学会假边测试。画出你当前的工作流,找出那些不承载数据的边,删掉它们。这一个动作,就能让你在碰任何新工具之前,比大多数人更快。
大多数人会继续把步骤排成一列。少数学会画图的人,将指挥一整队 Agent。
如果你想紧跟 AI 领域发生的一切,请在 X 和 Telegram 上关注我:
X - https://x.com/AnatoliKopadze
Telegram - https://t.me/kopadzemp