为 GPT-6 Astra 重新审视 Skill 与 Prompt
Coding Agent 已经进步了很多,最佳实践也在快速变化。过去需要大量手把手引导和脚手架的事情,现在已经不需要了。
如果过去一年你一直在项目里使用 Agent,那么为了把模型引导到好的结果,你很可能已经积累了一大堆臃肿的指令。每次新模型发布,都值得重新审视这些假设;而到了 GPT-6 Astra,这件事比以往任何时候都重要。
这些指令有多种形式:Skill、AGENTS.md,以及你的任务 prompt,都在塑造模型完成工作的方式。
Skill 文件
指令的一种形式是 skill 文件。它本质上是以 markdown 文件存放的 prompt,有时还会附带脚本。一般来说,它们最适合用来指导模型只在特定任务中才需要的工作流,或者说明某个插件怎么用。
很多人习惯性地往项目里下载一大堆 skill,这是个错误。每个 skill 都带有名称和描述,它们会被加载进模型的上下文,让模型知道何时该用。很多描述实在太长了;当你加入过多 skill 时,Codex 会开始截短这些描述以便塞进上下文。结果就是模型看到的每条描述都变少了,更难判断该选哪个 skill。
更糟的是,描述之间可能互相矛盾,或者太有“选我选我”的劲头,导致模型加载了对当前任务并无帮助的指令。
如果你曾让 Codex 创建过 skill,它多半用的是 $skill-creator 这个 skill。我们最近从几个方面更新了它的指导,以缓解我们在实践中见到的许多失败模式。
第一,skill 的描述应尽可能短,同时把模型何时该用它说清楚。
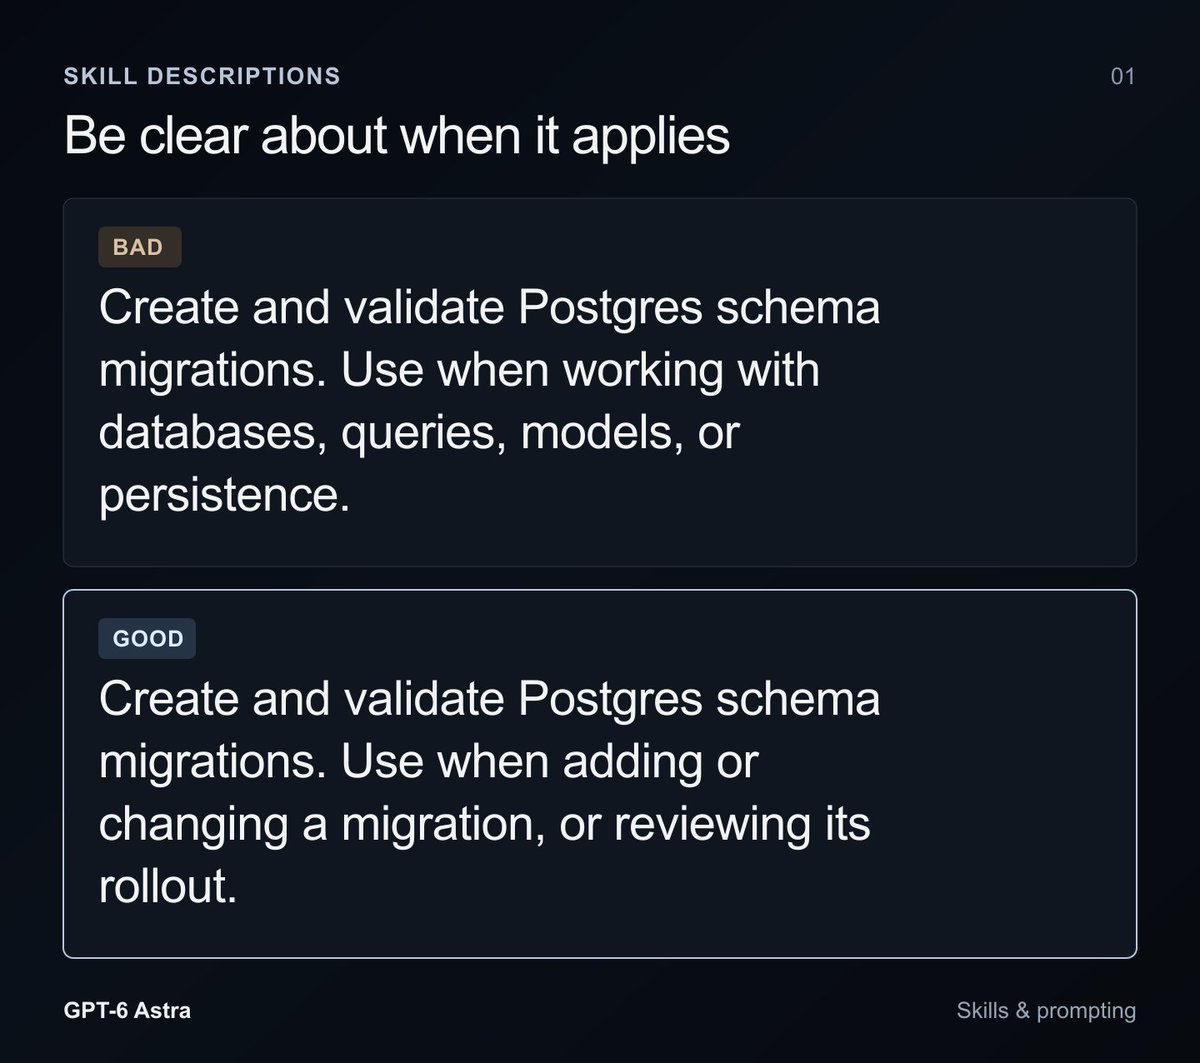
(译注,图 1 内容:坏例子——“创建并校验 Postgres schema migration。凡涉及数据库、查询、模型或持久化时使用。”好例子——“创建并校验 Postgres schema migration。在新增或修改 migration、或审查其上线发布时使用。”)
这里,坏的 skill 描述会让模型只要碰到跟数据库沾边的事就去用它,而不是只在需要处理 migration 时才用。
第二,一个有用的 skill 的关键标志之一是渐进式披露(progressive disclosure)。读取一个 skill 会占用上下文,让你更快逼近 compaction,还会引入可能与当前任务无关的指导。对于包含多个工作流的 skill,把根文档做成一个极简的路由器,指向配套的文档和脚本。给模型足够的指引让它知道去哪里找,但不要强迫它读那些此刻无关紧要的内容。
第三,很多 skill 被写成了事无巨细的行程单或菜谱。模型理解细微差别和模糊表述的能力已经强得多,因此过于具体的指导,以前有帮助,现在反而可能拖累结果。
仓库里的 skill 也会指导其他贡献者的 Agent,而它们用的可能是不同的模型。对 Sol 或 Luna 有帮助的指导,可能会把 GPT-6 Astra 约束过头,所以要考虑清楚:你留下的这些指令,将来会由哪些模型来使用。
AGENTS.md
只要模型在你的仓库里工作,AGENTS.md 就会生效,所以要重新审视其中每一条指令,问问自己:任务是否仍然需要它?
要求每次编辑前都先读一摞文档或整个仓库地图,对于修个错别字来说太过头了。GPT-6 Astra 自己就能弄清需要读什么,不需要被推着在每次改动前把整个项目过一遍。
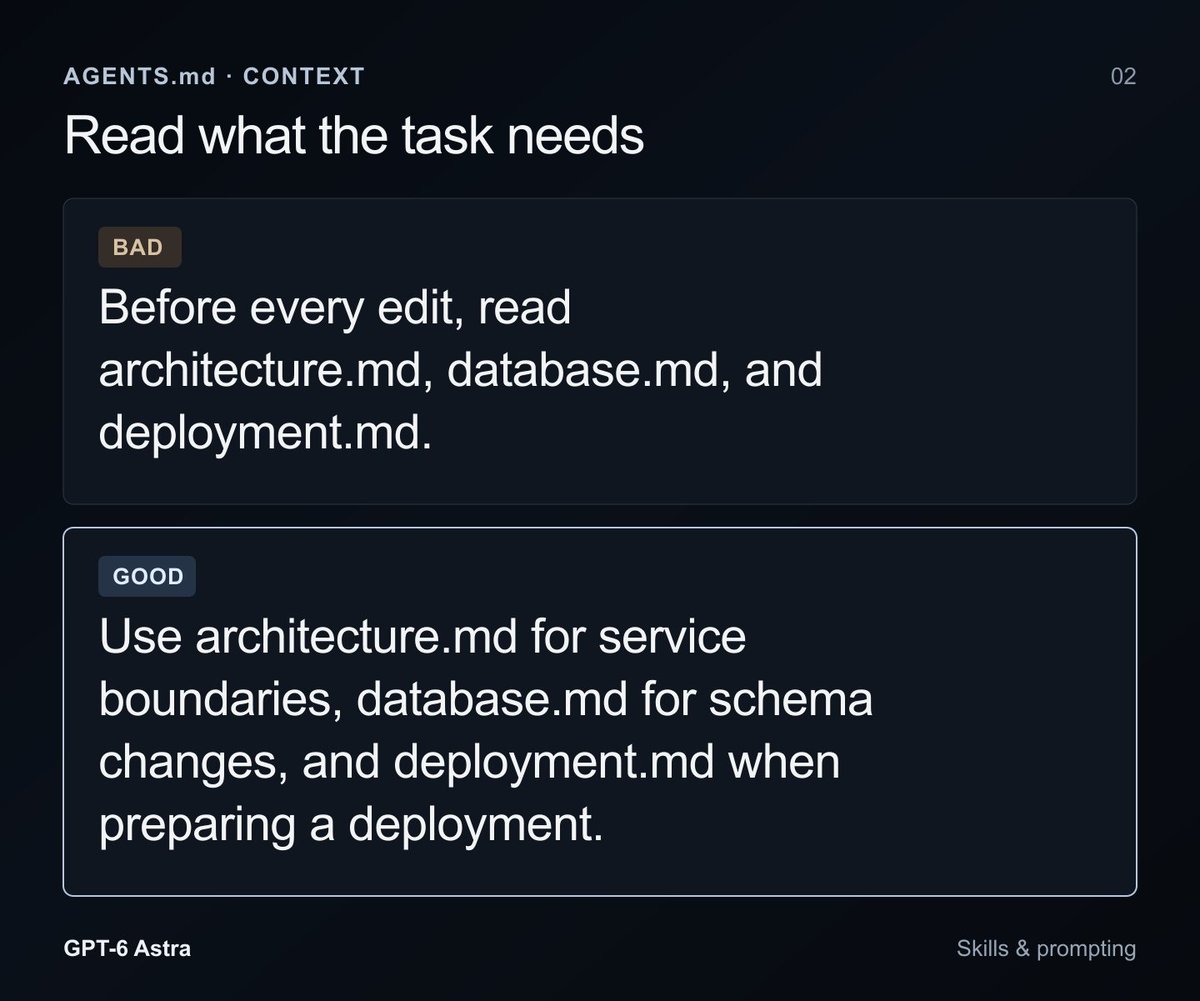
(译注,图 2 内容:坏例子——“每次编辑前,先读 architecture.md、database.md 和 deployment.md。”好例子——“服务边界看 architecture.md,schema 变更看 database.md,准备部署时看 deployment.md。”)
让模型在每次编辑前都先读文件,是烧掉上下文、拖慢工作的绝佳方式。不过,指向某些文档仍然有用,前提是它得与具体情境相关。另外,记得让你的文档保持更新!
以前的模型需要鼓励才会去跑测试、检查自己的工作。GPT-6 Astra 会自己做这些,所以同样的指令反而会导致不必要的测试。
GPT-6 Astra 做事很彻底,但在一项任务该推进到什么程度上,它可能更犹豫。有时它需要一点推力才会继续。你可以用 AGENTS.md 针对某个你确认安全的工作流给它授权,比如本地测试套件:
本地测试使用一次性的 fixture,且无法访问生产环境。直接运行它们,修复由本次改动引起的失败,并重新运行受影响的测试,无需在每一步都请求批准。
决策边界
要格外留意你描述边界的方式。如果之前的模型曾未经许可就替你做了事,你可能已经加上了措辞强硬的指令,要求它先问再做。这可能有用,但 GPT-6 Astra 的判断力好得多,你应该把它当作这样的模型来对待。它也会认真对待你的边界,可能在你其实乐意让它继续的地方停下来。
持续推进
如果你已经习惯了 GPT-5.6 Sol 接到一个请求后能长时间持续推进,那么 GPT-6 Astra 在何时停下这件事上会显得更犹豫。它可能在完成第一版实现后就回来找你 review,而这时其实还有活没干完。
这就是为什么在开始之前先定义好“什么叫完成”会很有帮助。如果任务包括把实现跑起来、检查结果、修复失败项,那就把这些写进请求里。“第一版实现完成后停下来等 review”这样的要求会把模型拉向一个更早的停止点,所以先想清楚:这真的是一个需要你来做的决定吗?
如果你希望它在第一遍之后继续探索,就说明你想探索什么,以及它应该在哪里停下。
新模型是一个大扫除的好时机。让 GPT-6 Astra 基于本文讨论的内容做一次审计,然后去构建一些你以前不敢尝试的东西吧!