Grok Bot 的正确用法:多数人跳过的 18 条配置法则
How to actually use Grok Bot. 18 rule setup most users skip 原文发布于

Grok Bot 问世才 16 天,大多数教程就已经在教错误的东西了。
它们教你怎么创建一个研究 Bot、一个写作 Bot、一个销售 Bot、一个编码 Bot、一个幕僚长(Chief of Staff)。然后再放一张截图:侧边栏里坐着十个五颜六色的 AI 员工。
看起来很有未来感。但一排 Bot 并不等于一家 AI 公司。那只是十个你现在得亲自管理的新同事。
真正从 Grok Bot 里榨出杠杆的人,发现的却是另一回事:
单个 Bot 不是产品。Bot 之间的系统才是。
Grok Bot 可以保存持久状态、操作一台云端电脑、使用网站和已接入的工具、在你合上笔记本后继续运行、由事件触发工作、与其他 Bot 通信、在获准时访问你的本地电脑,甚至还能另行启动 Cursor Cloud Agents 去做实现工作。
这改变了游戏规则。
你要做的不是打造一个最聪明的助手,而是设计一个组织:信息流向正确的执行者,证据在交接中不丢失,例行工作无需你插手,错误沉淀为规则,只有真正需要你拍板的决策才会回到你手上。
中国的重度用户已经开始用这种方式描述 Grok Bot 了。一个真实的小红书工作流主要把 Grok Bot 当作调度员:云端模型负责重度认知工作,本地 Cursor 产出证据和真实截图,专职 Bot 打包结果,人类保留最终的发布决定权。
这才更接近真正的解锁点。下面是搭建方法。
📁 grok-bot-org
┃
┣ 📂 coordinator
┃  ┣ /triage
┃  ┣ /delegate
┃  ┣ /watch-handoffs
┃  ┣ /collect-deliverable
┃  ┗ /escalate-only-if-needed
┃
┣ 📂 bot-contract
┃  ┣ /job
┃  ┣ /sources
┃  ┣ /judgment
┃  ┣ /output
┃  ┗ /forbidden
┃
┣ 📂 hire-by-bottleneck
┃  ┣ /wait-on-research
┃  ┣ /wait-on-verification
┃  ┣ /wait-on-writing
┃  ┣ /wait-on-execution
┃  ┗ /repeated-rework
┃
┣ 📂 shared-computer
┃  ┣ /one-vm-all-bots
┃  ┣ /minimum-access
┃  ┣ /read-only-first
┃  ┗ /scoped-service-accounts
┃
┣ 📂 /workspace  (internal bus)
┃  ┣ /research
┃  ┣ /drafts
┃  ┣ /evidence
┃  ┣ /reviews
┃  ┣ /approved
┃  ┗ /archive
┃
┣ 📂 handoff-packet
┃  ┣ /task
┃  ┣ /status
┃  ┣ /output
┃  ┣ /sources
┃  ┣ /decisions
┃  ┣ /uncertainties
┃  ┗ /next-owner
┃
┣ 📂 memory-policy
┃  ┣ /store-preferences
┃  ┣ /store-style
┃  ┣ /store-rules
┃  ┣ /never-prices
┃  ┣ /never-balances
┃  ┗ /reopen-source
┃
┣ 📂 local-bridge
┃  ┣ /cloud-for-orchestration
┃  ┣ /local-for-evidence
┃  ┣ /local-for-screenshots
┃  ┗ /explicit-permission
┃
┣ 📂 cloud-agents
┃  ┣ /tech-lead-bot
┃  ┣ /parallel-workers
┃  ┣ /scope-per-agent
┃  ┣ /acceptance-criteria
┃  ┗ /consolidated-report
┃
┣ 📂 model-routing
┃  ┣ /routing
┃  ┣ /mechanical
┃  ┣ /deep-reasoning
┃  ┣ /execution
┃  ┗ /verification
┃
┣ 📂 skills  (earned, not written)
┃  ┣ /when-to-use
┃  ┣ /process
┃  ┣ /decision-rules
┃  ┣ /output-contract
┃  ┣ /failure-states
┃  ┗ /lessons-from-failures
┃
┣ 📂 three-gates
┃  ┣ /source-gate
┃  ┣ /evidence-gate
┃  ┗ /action-gate
┃
┣ 📂 triggers
┃  ┣ /event-based
┃  ┣ /narrow-filters
┃  ┣ /no-polling
┃  ┗ /wake-on-signal
┃
┣ 📂 silent-routines
┃  ┣ /notify-on-exception
┃  ┣ /notify-on-threshold
┃  ┣ /idempotent-retries
┃  ┗ /partial-completion
┃
┣ 📂 audit
┃  ┣ /action-log
┃  ┣ /sample-review
┃  ┣ /failure-patterns
┃  ┗ /rules-to-add
┃
┣ 📂 auto-review
┃  ┣ /always-allow-narrow
┃  ┣ /require-approval-wins
┃  ┣ /action-class-not-personality
┃  ┗ /not-a-security-boundary
┃
┣ 📂 identities
┃  ┣ /read-only-connector
┃  ┣ /scoped-service-account
┃  ┣ /dedicated-bot-account
┃  ┗ /never-personal-master
┃
┗ 📂 disposable-infra
   ┣ /workspace-durable
   ┣ /version-control
   ┣ /repeatable-setup
   ┗ /rebuild-anytime
第一部分 — 从这里开始
1. 你的第一个 Bot 不应该亲自干活

最直觉的配置,是建一个什么都能干的幕僚长。别这么做。
你的幕僚长应该被刻意设计成不够格干生产工作。它的职责是:
分诊 → 委派 → 跟进 → 收集 → 上报
仅此而已。一旦你的幕僚长开始自己做研究、写作、设计、核对数字、操作网站,你就又造出了那个你本想逃离的巨型聊天机器人。
我找到的最好的中国 Grok Bot 工作流之一,最终正是落到了这种结构上:用户只和一个协调者对话,而独立的内容、情报和视觉工作者在幕后接收任务。协调者负责交接并闭环。
SpaceXAI 官方指南也指向同一个方向:当每个 Bot 各自对一个明确的结果负责时效果最好,而 Bot 之间、群组之间可以相互传递工作,人类就不必一直充当路由器。
给你的幕僚长这段话:
You are my Chief of Staff.

Your primary job is NOT to perform specialist work.
Your job is to:

1. Understand the outcome I want.
2. Decide who should own each part.
3. Delegate to the smallest number of appropriate specialists.
4. Track unfinished handoffs.
5. Resolve conflicts between specialists.
6. Collect the final deliverable.
7. Bring me in only when my judgment, permission, or missing
   information is genuinely required.

Before doing substantial work yourself, ask:
"Is there a specialist who should own this?"
If yes, delegate.

You own routing and closure.
You do not become the researcher, writer, designer, engineer,
analyst, or operator unless no specialist exists.
2. 按瓶颈招人,而不是按软件招人

人们自然而然会创建:
- Gmail Bot
- Chrome Bot
- Slack Bot
- Notion Bot
- X Bot
这是本末倒置。人类也不是这么组织的。你不会招一个「Chrome 员工」,你招的是负责营收的人、负责研究的人、负责客户成功的人、负责财务的人、负责发布的人。
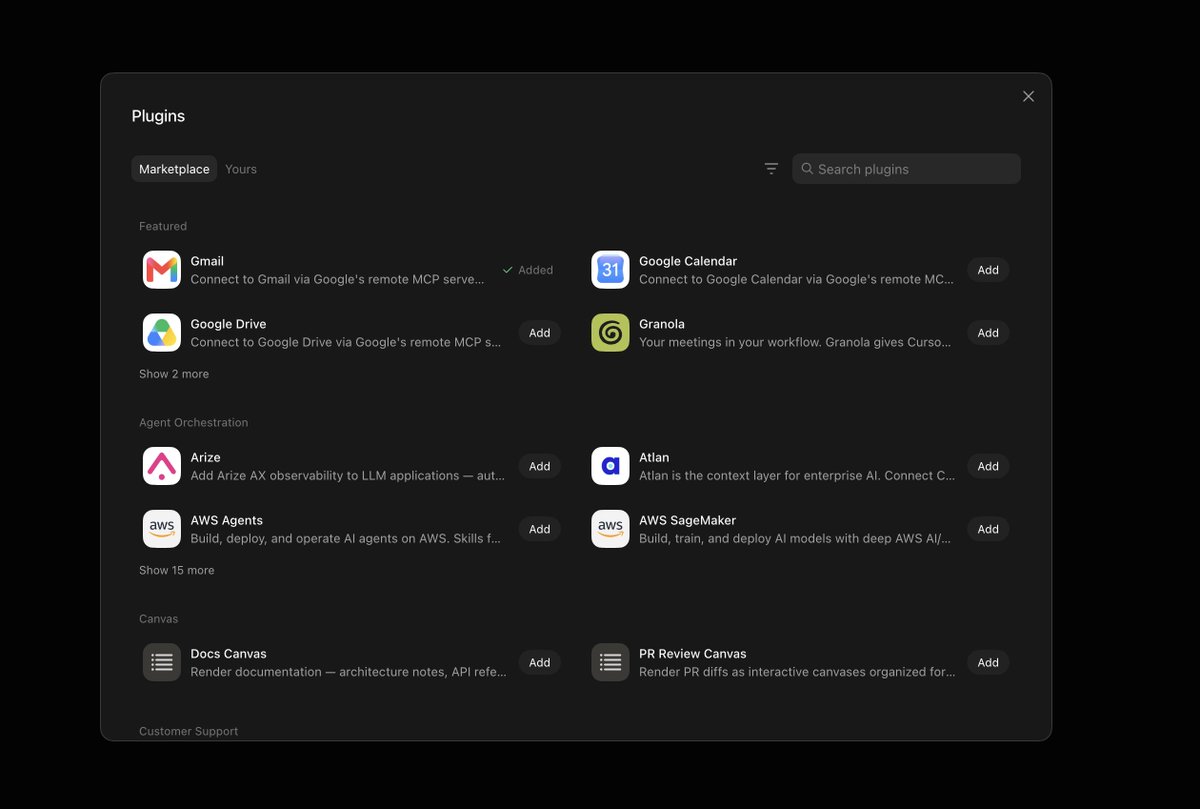
那个应用市场视图正是大多数人失足的地方。每个图标都在低语「为我招一个 Bot 吧」。抵制它。把上面那份名册和这里的市场对比一下:一个按结果组织,另一个按供应商组织。只有前者能经得起真实工作的考验。
中国的 Grok Bot 社区对此有一个很有用的思考方式:
在工作被卡住的地方拆分组织。
如果研究反复阻塞发布,就招一个情报 Bot。如果视觉素材阻塞发布,就招一个视觉制作 Bot。如果核对数字阻塞了一切,就招一个核验员。
那个真实的小红书实践一开始只有协调者和情报两个角色。只有当实际工作流的复杂度造成了反复出现的瓶颈时,才增设新岗位。
SpaceXAI 同样建议:只有当工作拥有独立的目标、信息源集合、工作方式、审批边界或长期职责时,才创建另一个 Bot。
问你的幕僚长:
Do not design my Bot team from the apps I use.
Design it from my recurring bottlenecks.

Analyze the last 2 weeks of work I described and identify:
- work that repeatedly waits on me
- work that repeatedly waits on research
- work that repeatedly waits on verification
- work that repeatedly waits on writing
- work that repeatedly waits on execution
- work that repeatedly gets forgotten
- work I repeatedly redo because the previous output was wrong

Propose a new Bot only where one bottleneck occurs often enough
to justify a permanent owner.

For every proposed Bot tell me:
  Bottleneck:
  Owner:
  Outcome:
  Why this deserves a separate Bot:
  What this Bot must NOT do:
不要因为另一个 AI 存在就去招 AI。要因为某处有工作在等着,才去招。
3. 每个 Bot 需要的是一份契约,而不是一种人格
「做一个世界级的营销人。」「像 Steve Jobs 一样思考。」「要极其聪明。」
基本没用。
一个 Bot 需要的是一份运行契约。一份中国的 Grok Bot 实战手册把一个好角色简化为四个实用字段:职责 + 信息源 + 判断标准 + 汇报格式。我会再加第五个:禁止事项。
于是你得到:
JOB        — What outcome do you own?
SOURCES    — Where are you allowed to get facts?
JUDGMENT   — How do you decide what is good, bad, important,
             risky, or complete?
OUTPUT     — Exactly what must you hand to the next person?
FORBIDDEN  — What are you explicitly not responsible for?
例如:
JOB
Find high-signal AI developments worth publishing about.

SOURCES
Official company accounts, release notes, GitHub, selected
researchers, primary papers and the approved monitoring list.

JUDGMENT
Prioritize:
- genuinely new information
- measurable changes
- unusual technical details
- implications our audience can use

Reject:
- recycled announcements
- vague founder quotes
- unsupported rumors
- engagement bait with no underlying event

OUTPUT
For every accepted item return:
1. one-sentence finding
2. original source
3. why it matters
4. what changed
5. confidence
6. suggested content angle

FORBIDDEN
Do not write the final article.
Do not fabricate personal experience.
Do not publish.
Do not turn secondary reporting into a primary source.
现在你的内容 Bot 收到的是干净的素材,而不必耗掉一半上下文去猜研究 Bot 到底想表达什么。
4. 让公司从错误中生长
这是我在中文资料里找到的最好的想法之一。
不要试图在第一天就写出一份完美的 4000 字宪法。去跑真实的工作。当系统犯下一个会重复出现的错误时:
把这个错误变成一条永久规则。
在一个中国的生产工作流里,系统并不是靠一条巨型主提示词打磨完美的。标题超出了预期格式?加一条新规则。用错了图片来源?加一条新规则。一个看起来像假的输出顶替了必需的真实证据?加一条新规则。同一个失败绝不应该第二次消耗所有者的时间。
人类建公司也是这么建的。政策就是累积起来的疤痕组织。
每次纠正之后,使用:
We just found a failure in our operating system.

FAILURE:          [what happened]
WHY IT MATTERED:  [impact]
CORRECT BEHAVIOR: [what should happen instead]

Determine where this rule belongs:
- Bot job contract
- Skill
- Source policy
- Approval policy
- Handoff contract
- Routine
- Global operating rule

Add it in the narrowest place that prevents this exact class
of failure without unnecessarily restricting unrelated work.

Then tell me:
  OLD BEHAVIOR
  NEW RULE
  WHERE IT WAS SAVED
  HOW WE WILL TEST IT
如果同一个错误你手动纠正了三次,你就不再是在管理 AI,而是在做无偿 QA。
第二部分 — Grok Bot 的架构和多数人想的不一样
5. 你的 Bot 并没有各自独立的电脑
这是理解 Grok Bot 最重要的事实之一。
营销话术很容易让人以为每个 Bot 都有一台单独的机器。并不完全是这样。
官方文档说,**你的所有 Bot 共享一台分配给你用户账号的持久云端电脑。**每个 Bot 有自己的屏幕,所以多个 Bot 可以并行操作。但这台机器上的文件、浏览器会话、登录态和命令行凭据,可能对整个 Bot 名册都可用。
不同的 Bot ≠ 不同的安全边界。
这带来两个巨大的后果。
**好的一面。**登录一次,多个 Bot 就有可能接着把工作流跑下去。研究产出一个文件,写作者接手,协调者检查。你不必为每个队友重建环境。
**危险的一面。**创建一个「财务 Bot」,在技术上并不能把你的银行会话和「内容 Bot」隔离开。
所以别再想哪个 Bot 应该有访问权限?要开始想这台共享电脑上到底应该存在什么?
用这段话审计你的配置:
Audit everything currently accessible from our shared
Grok Bot computer.

For every:
- browser login
- connector
- credential
- file
- API access
- command-line credential
- service account

classify it:
  NEEDED BY MANY BOTS
  NEEDED BY ONE WORKFLOW
  TEMPORARY
  UNNECESSARY
  HIGH-RISK

Then recommend the minimum-access architecture.
Do not treat different Bots as security isolation.

Prefer: read-only access, scoped service accounts,
temporary access, and explicit approval for consequential
actions.
仅这一个架构细节,就应该改变你配置整个团队的方式。
6. /workspace 应当成为你公司的内部总线
大多数人让 agent 通过聊天来协作。研究 Bot 写一条巨长的消息,写作者收到巨长的消息,审阅者再收到另一条巨长的消息。上下文被压缩,来源消失,数字失去出处。
相反,要让 agent 交接工件(artifact)。
共享机器让 Bot 可以通过共享文件传递上下文,而官方安全指南也明确提到用 /workspace 存放项目文件。
建这样的文件夹:
/workspace/research/
/workspace/drafts/
/workspace/evidence/
/workspace/reviews/
/workspace/approved/
/workspace/archive/
然后定义一份交接包:
Every specialist handoff must create an artifact.
Do not hand substantial work to another Bot only through chat.

Create HANDOFF.md containing:

TASK           — What you were asked to accomplish.
STATUS         — Complete / partial / blocked.
OUTPUT         — The actual deliverable.
SOURCES        — Original links, files, timestamps, screenshots.
DECISIONS      — Important judgment calls you made.
UNCERTAINTIES  — Anything you could not verify.
NEXT OWNER     — Who should continue the work.
DO NOT ASSUME  — Information the next Bot must re-check.

Save supporting files beside the handoff.
现在你的组织拥有了比 AI 记忆珍贵得多的东西:机构化的证据。
7. 记忆应当存偏好,永远不要存事实
Bot 会记东西。这听起来很棒,直到被记住的信息变了。
你当前的价格、客户状态、库存、账户余额、活动效果、产品规格、截止日期、某家公司里都有谁。
这些不是记忆。它们是等着被执行的数据库查询。
SpaceXAI 明确警告:Bot 的记忆不能替代权威来源,并建议在做有后果的决策时重新打开当前数据。
在整个团队中使用这条规则:
MEMORY POLICY

Memory is allowed for:
- my preferences
- writing style
- stable definitions
- recurring formatting
- working relationships
- durable operating rules
- how I like decisions presented

Memory is NOT authoritative for:
- prices
- balances
- dates
- availability
- campaign metrics
- account status
- customer state
- employee state
- contracts
- market data
- changing technical documentation
- anything consequential that can become stale

For changing facts:
  reopen the authoritative source before using the value.
  If the source cannot be reached, say SOURCE UNAVAILABLE.
  Never silently substitute remembered data.
好的 agent 不是什么都记得。它知道哪些东西不该信任自己的记忆。
8. 你的云端员工能碰到你真实的笔记本电脑
这个功能出奇地容易被忽略。
Grok Bot 的云端电脑和你面前那台实体 Mac 或 Windows 是两个独立的环境。但如果你启用本地执行,Bot 也可以在本地机器上干活。
对于团队环境,官方文档说这可以包括运行命令、读取文件,以及在云端与本地电脑之间移动文件。本地执行有单独的权限控制,只应在工作流确实需要时才启用。
这造就了一种非常有意思的架构:
云端负责编排,本地负责私有证据或依赖特定机器的工作。
这几乎正是一个高阶的中国工作流独立摸索出来的结论:云端模型处理重度综合分析,本地 Cursor 产出真实的报告和截图;Grok Bot 协调这些工件该去哪儿。
示例:
For this workflow:

Use cloud resources for:
- research
- reading
- synthesis
- planning
- coordination

Use my local computer ONLY when required for:
- local project files
- local scripts
- real screenshots
- locally generated reports
- machine-specific evidence

Before local work:
1. Explain why cloud execution is insufficient.
2. State exactly what local command or file access is needed.
3. Use the smallest possible scope.
4. Return the resulting artifact to /workspace/evidence/.
5. Do not modify unrelated local files.
这远比「AI 有一台云端电脑」强大。你可以创建横跨两台信任角色不同的电脑的工作流。
9. Grok Bot 可以成为编码 agent 的经理
架构从这里开始变得奇特。
你的 Grok Bot 不必是开发者本人。
对于团队,SpaceXAI 记载了一项 Cloud Agents 设置,允许 Grok Bot 启动 Cursor Cloud Agents,而且在当前的团队配置流程中默认开启。Cursor Cloud Agents 本身运行在隔离的虚拟机里,拥有完整的开发环境。
于是形成了:
                        YOU
                         ↓
                GROK BOT (tech lead)
                         ↓
        ┌────────────────┼────────────────┐
        ↓                ↓                ↓
  Cloud Agent A    Cloud Agent B    Cloud Agent C
    frontend         backend           tests
        └────────────────┼────────────────┘
                         ↓
            GROK BOT (review / coord)
                         ↓
                        YOU
不要对 Grok Bot 说把整个功能实现出来,而是告诉它:
You are the technical lead, not the only engineer.

For this project:
1. Break the work into independently testable units.
2. Determine which units can run in parallel.
3. Launch the minimum number of Cursor Cloud Agents required.
4. Give every agent:
   - exact scope
   - repository/context
   - acceptance criteria
   - tests required
   - explicit non-goals
5. Track their progress.
6. Inspect their outputs.
7. Resolve conflicting implementations.
8. Run final verification.
9. Return one consolidated engineering report.

Do not duplicate implementation work already assigned to
a Cloud Agent.
社区里的一个编码工作流已经把这一点推得更远:由一个负责的 Grok Bot 对仓库结果负全责,并在实现工作出现分支时创建更多编码工作者。
关键的心智转变:
一个 AI 不一定要亲自执行整项工作。它可以拥有这项工作,而由其他算力来执行。
10. 别再纠结 Grok Bot 用的是哪个模型
重度用户最爱问:这个 Bot 跑的是哪个模型?
但 Grok Bot 越来越像一个编排界面,而不只是某个模型的外壳。
当前的企业版文档说,Grok Bot 本身在那里并不提供模型选择器;产品会在一组固定的模型之间路由请求并自动故障转移,用量分析可以显示实际是哪个模型服务了某次请求。与此同时,Cursor Cloud Agents 有自己的模型配置,而 Cursor 支持来自多家提供商的模型。高阶社区工作流已经更进一步,把外部模型或系统作为工具/MCP 能力暴露出来。
前面提到的那个中国工作流,就是实实在在地用其他云端模型做重度认知,再用 Grok Bot 编排结果。
所以,与其问怎样把每个任务都强行塞进最聪明的模型?,不如问每个阶段最便宜且可靠的执行者是谁?
For this workflow, separate work into:

ROUTING         — Understanding who should own the task.
MECHANICAL      — Extraction, transformation, formatting.
DEEP REASONING  — Ambiguous analysis where mistakes are expensive.
EXECUTION       — Browser, terminal, coding or external-tool work.
VERIFICATION    — Independent checking of important claims.

Do not use the most expensive or capable path simply because
it exists.

Use Grok Bot primarily to preserve the outcome, context,
routing and quality bar. Delegate specialist execution to the
appropriate available tool, Bot, Cloud Agent or connected system.
这可能最终会成为关于 Grok Bot 最大的洞见:
Grok Bot 不必是你公司里最聪明的智能,也能成为你公司里最重要的智能。
第三部分 — 大多数人都搞错的自动化环节
11. 不要去写完美的 Skill。要通过真实工作把它挣出来。
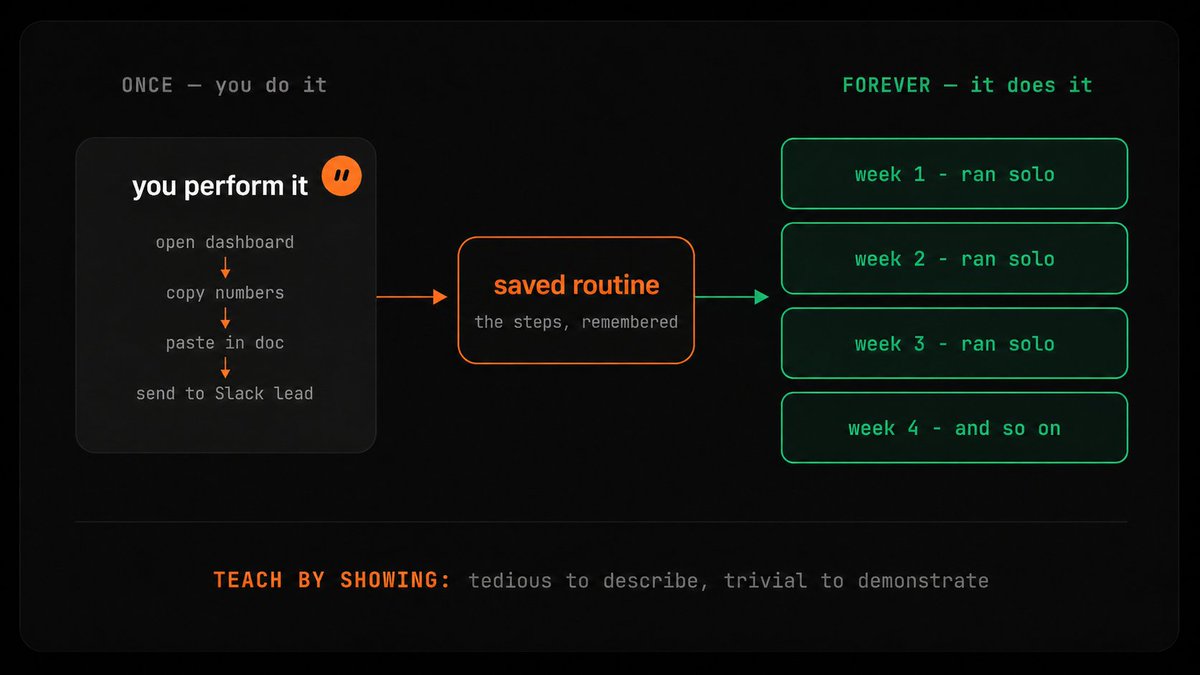
大多数人是这样做自动化的:
- 想象一个完美的工作流。
- 写一条巨型提示词。
- 把它排上日程。
- 凌晨 3 点发现 17 个边界情况。
更好的顺序是:
真实任务 → 纠正 → 第二个真实任务 → Skill → 测试 → Routine
这也是 SpaceXAI 推荐的顺序。它还和我找到的最扎实的中国实战报告吻合:那个工作流只有在真实输入暴露出标题问题、来源错误、图片问题和窗口/工具冲突之后,才变得可靠。这些失败被转化成了持久的规则。
当一个任务终于跑通之后,说:
Do not automate this yet.

Extract the method that succeeded.

Create a draft Skill containing:
  WHEN TO USE
  INPUTS
  AUTHORITATIVE SOURCES
  PROCESS
  DECISION RULES
  VALIDATION
  OUTPUT CONTRACT
  FAILURE STATES
  APPROVAL BOUNDARIES
  FORBIDDEN ACTIONS

Also include:
  LESSONS FROM FAILED ATTEMPTS
  (list every correction I gave during this task and turn
  each repeatable correction into a rule)

Then test the Skill on a different real example.
Only after that should we discuss a Routine.
你最好的 Skill 不是你能写出的最聪明的提示词,而是此前所有出过的问题的压缩史。
12. 在每个严肃的自动化前面设三道关卡
这大概是我从中国 Grok Bot 社区学到的最喜欢的技巧。
在一条小红书流水线获准反复运行之前,其所有者设立了三道硬边界:
- 来源关
- 证据/数字关
- 发布关
没有获批的来源素材,内容就不能继续。技术性论断和数字必须来自证据层。AI 可以准备发布包,但发布者仍然是人。
这个模式远远超出内容领域,可以推广到各处。
Domain       │ Source gate            │ Evidence gate            │ Action gate
─────────────┼────────────────────────┼──────────────────────────┼──────────────────────────
Sales        │ approved CRM / prospect │ verified company &      │ human approves outreach
             │ sources                 │ person facts            │
Finance      │ actual ledger / bank /  │ reconciled figures      │ human approves transfer
             │ export                  │                         │
Engineering  │ correct repo / spec     │ tests / build /         │ human approves prod change
             │                         │ reproduction            │
Research     │ primary sources         │ claim-level             │ human approves publication
             │                         │ verification            │
把这段放进每一个严肃的工作流:
This workflow has three mandatory gates.

GATE 1 — SOURCE
Before reasoning:
  Verify that required inputs come from an approved
  authoritative source.
  If not: STOP.

GATE 2 — EVIDENCE
Before producing a consequential conclusion:
  Verify every important number, factual claim and status
  against evidence.
  Separate: VERIFIED / INFERRED / UNKNOWN.
  If evidence is insufficient: STOP or mark incomplete.

GATE 3 — ACTION
Before any consequential external action:
  Prepare the exact action for review.
  Do not: send, publish, purchase, delete, transfer, sign,
  change production, or modify permissions without the
  required approval.

A Routine is never allowed to bypass a gate.
没有关卡的自动化,只是一场带着权限的定时幻觉。
13. 事件触发胜过轮询
假设你想让一个 Bot 捕捉客户升级投诉。天真的配置:每 10 分钟检查一次 Slack。
于是它不停地醒来。大多数运行一无所获。你为用量买单,制造噪音,还给怪异行为创造了更多机会。
Grok Bot 的 Routine 可以由受支持的事件触发,例如匹配到的 Slack 消息或 GitHub 通知。SpaceXAI 明确警告不要设置「每条新消息」这种宽泛的监听器,因为它们会制造噪音并消耗用量。
不要这样:
Every 10 minutes check #support.而要这样:
When an event is available from #customer-escalations:

Only trigger when ALL are true:
- message contains a support ticket URL
- customer severity is P1 or P2
- message contains "needs repro" or equivalent escalation language

Then:
1. Open the ticket.
2. Gather current evidence.
3. Attempt reproduction in the approved environment.
4. Create a repro package.
5. Notify me only if:
   - reproduction succeeds
   - important information is missing
   - the issue meets escalation criteria

Otherwise finish silently.
Never post externally without approval.
你不想要一个不停问*有什么活儿吗?*的 AI 员工。你想要的是工作来把它唤醒。
14. 好的 Routine 大部分时间是沉默的
人们把自动化配置成产出报告。每天早上:*这是我检查过的 34 件事!*恭喜,你把工作换成了阅读关于工作的汇报。
一个有用的无人值守 Bot,经常应该什么可见的事都不做。它应该浮现的是异常、决策、失败、有意义的变化、高价值机会。而不是证明自己醒着。
Grok Bot 官方指南建议定义:数据过期时的行为、无数据时的行为、幂等重试以及部分完成的汇报方式。
建立「静默成功」规则:
This Routine operates by exception.

SUCCESSFUL NORMAL STATE:
  Do not message me.

Notify me only when:
- a threshold is crossed
- a new meaningful item appears
- the source becomes unavailable
- stale data would affect the result
- a task fails after safe retries
- an approval is required
- a human decision has material value
- the result differs materially from the previous run

RETRY POLICY:
  Retries must be idempotent.
  Do not repeat: messages, purchases, uploads, record creation,
  or other external mutations.

  If partial work succeeds: preserve it and report only the
  blocked remainder.
衡量一个自动化好坏的标准,不是它说话的频率,而是你多么难得才需要操心它一次。
第四部分 — 构建一个你真正能信任的系统
15. 建立证据轨迹,因为完整的可审计性尚未到来
企业版文档里最少被讨论的细节之一:SpaceXAI 目前只暴露用量/花费信息,而对 Bot 行为更全面的审计视图被描述为即将推出。
这意味着严肃的用户不应等待完美的可观测性。现在就自建一套轻量的审计轨迹。
对每一个有后果的工作流:
Maintain an ACTION_LOG.md.

For every run append:
  TIMESTAMP
  BOT
  TRIGGER
  REQUESTED OUTCOME
  SOURCES ACCESSED
  FILES CREATED OR MODIFIED
  IMPORTANT CLAIMS
  EXTERNAL ACTIONS ATTEMPTED
  EXTERNAL ACTIONS COMPLETED
  APPROVALS REQUESTED
  APPROVALS RECEIVED
  FAILURES
  UNVERIFIED ITEMS
  FINAL STATUS

Do not store passwords, tokens, one-time codes, or
unnecessary sensitive content in the log.
然后让另一个 Bot 抽样审计:
Every Friday:

Select 5 completed runs involving consequential decisions.

Independently inspect:
- source quality
- unsupported claims
- incorrect numbers
- ignored approval boundaries
- repeated failures
- unnecessary tool calls
- avoidable human interruptions

Return:
  PASS RATE
  REPEATED FAILURE PATTERNS
  RULES WE SHOULD ADD
  RULES WE SHOULD REMOVE
  BOTS THAT NEED RETRAINING
这就是在你不必重读每一个任务的情况下,让系统变得更好的方式。
16. Auto-review 是一个策略引擎,不是一道力场

Grok @Bot 可以依据 Auto-review 规则评估动作。一个出奇有用的细节:
当两条规则同时匹配时,「需要审批」优先于「始终允许」。
@SpaceXAI 也明确警告:Auto-review 是基于模型的,不应被当作安全边界。
所以不要写始终允许使用浏览器。写窄规则。
ALWAYS ALLOW
- read approved public sources
- create drafts in /workspace/drafts
- run read-only repository inspection
- create internal analysis files

REQUIRE APPROVAL
- external email
- public posts
- purchases
- financial actions
- permission changes
- deleting external data
- modifying production
- accepting contracts or terms
- uploading sensitive information关键思想:自主权应按动作类别授予,而不是按 Bot 人格授予。
不要说我信任研究 Bot。要说我信任来自这些来源的只读研究。这句话安全得多。这正是上图所画的分界:36 份草稿排队,0 封已发送——Bot 把所有可逆的事都做了,然后恰好停在那件不可逆的事前面。
17. 给 AI 员工独立的身份,而不是你的身份
由于所有 Bot 可以共享同一台云端机器和会话,到处使用你自己的主账号会带来另一个问题:外部系统看到的是你。它们天然不知道是哪个内部 Bot 造成了哪种行为。
更好的模式是在服务支持的情况下创建限定范围的服务身份:
- 专用邮箱
- 受限的社区账号
- 只读的分析用户
- 限定范围的 CRM 席位
- Bot 专属的 API/服务账号
SpaceXAI 自身也建议在源系统支持时使用限定范围的服务账号和最小权限。早期的 Grok Bot 重度用户已经各自独立地采用了专用的 agent 邮箱/账号,让 agent 能像员工一样被邀请进系统,而不是拿到所有者的凭据。
问:
For every external system in this workflow, choose the
safest identity:

  A. Read-only connector
  B. Scoped service account
  C. Dedicated Bot/employee account
  D. My personal account
  E. No access

Prefer A-C.

For the selected identity define:
- permissions required
- permissions explicitly unnecessary
- data it can see
- actions it can perform
- how activity can be attributed
- how access is revoked
- what still requires my approval

Never request broader access simply because it is easier.
一家真正的公司绝不会把创始人的密码交给每个实习生。别做这件事的数字版本。
18. 把 Grok Bot 的电脑当作一次性基础设施
这是我发现的最古怪却有用的细节之一。
Grok Bot 的对话历史与云端机器是分开存储的。Cursor 的恢复文档说,即使删除了那台机器里的文件,也不会自动销毁对话历史,而且同步过的沙箱状态通常可以从持久的服务端存储中重新恢复。你自己 Mac 或 Windows 上仅存于本地的文件则是另一回事,需要你自己备份。
Cursor 支持团队还记录过:在某些电脑刷新之后,可持久的位置包括 /workspace 里的项目文件、浏览器配置文件和配置目录,而其他机器状态可能无法保留。
这意味着你不该把云端电脑当作一台精心配置、永久呵护的手工服务器。把它当作可替换的基础设施。
你的重要状态应当存在于:
- 权威的外部系统
- /workspace
- 版本控制
- 可重复执行的搭建说明
- Skill
- Bot 契约
而不是藏在某个你三周前手动安装的软件包里。
使用:
Audit this Grok Bot computer for fragile state.

Identify anything important that currently depends on:
- manually installed software
- temporary directories
- undocumented machine state
- unsynced files
- shell history
- ephemeral sessions
- one-time manual configuration

For every dependency, move the durable truth to one of:
- /workspace
- version control
- an authoritative external system
- a repeatable setup script
- a documented Skill
- supported plugin/configuration

The machine should be rebuildable.
No critical business process should depend on remembering
how we manually configured this exact VM.
最好的 Grok Bot 系统应该经得起丢失它的电脑。因为组织不是那台电脑。组织是那些能重建工作的规则、来源、工件、角色和交接。
还有一件事:社区已经开始走野路子了
围绕 Grok Bot 已经出现了一个非官方生态。
开发者构建了诸如 Telegram 桥接之类的东西,可以在官方 Grok Bot 界面之外选择 agent、查看其状态并调用 Skill。其中一些项目依赖于 Grok Bot 环境暴露的一个未记录在案的内部网关。Cursor 员工承认社区围绕这些机制在做实验,同时也称它们尚未被文档化。
这很有意思。但也意味着:
暂时不要把你的生产级公司建在未文档化的内部机制上。
今天能用的端点明天就可能消失。受支持的产品本身已经在飞速演进。把你重要的工作流建在有文档的 Bot、Skill、Routine、插件、事件触发器、文件和 Cloud Agents 之上。其余的可以实验,但不要依赖。
真正的要点
大多数人会这样使用 Grok Bot:创建 12 个 agent,给每个都起个巧妙的名字,把一切连起来,把一切排上日程,看着它们干活,不停地修它们,烧掉用量,最后不再打开这个应用。
早期社区报告已经显示出这种失败模式:拥有复杂多 Bot 配置的用户抱怨 agent 卡住、审批过期、错过定时动作、电脑会话缓慢、插件故障,以及用量消耗快得出乎意料。Grok Bot 仍处于测试阶段。
答案不是一条更好的 2000 字提示词。而是更好的组织设计。
- 从一个协调者开始。
- 几乎不给它任何生产职责。
- 跑一个真实的工作流。
- 找到第一个瓶颈。
- 招一个专员。
- 定义它的事实来源。
- 定义它不能做什么。
- 让它产出工件。
- 在错误代价高的地方加一层独立核验。
- 再跑一遍工作流。
每个重复出现的错误都变成规则。每个可靠的流程都变成 Skill。每个成熟的 Skill 都配上 Routine。每个 Routine 都配上来源策略、证据策略、失败策略和动作边界。
用事件代替持续轮询。把会变的事实放在记忆之外。把关键状态放在机器之外。
让廉价或专用的执行者做机械工作。让更强的执行者处理困难的推理。让 Cloud Agents 实现代码。让 Grok Bot 协调。然后把最终那些不可逆的决策留在它们该在的地方——你手上。
最大的错误,是以为 Grok Bot 给了你 AI 员工。它没有。
它给你的是构建一个 AI 组织的原语。
这中间有巨大的差别。员工执行任务。组织决定谁拥有任务、事实存于何处、工作如何流转、谁来检查、失败了怎么办、以及什么时候该打扰老板。
一旦这些规则存在,单个模型就没那么重要了。单条提示词没那么重要了。甚至单个 Bot 也没那么重要了。
因为你终于拥有了一样比这三者都活得更久的东西。
一个系统。
附言
如果你读到了这里——你真的读完了全文,希望你从中有所收获。真心感谢你的时间和关注。
反馈对我非常重要。请留言告诉我你对这一切的看法——你同意什么、不同意什么、希望我在哪里再深入。有问题也尽管问,我会一一回答。
所有研究都是我自己做的,每样东西都先在我自己的配置上测试过才动笔。所以这份支持真的有意义。
如果这篇文章对你有触动——如果你能在下面 tag 一下 @elonmusk 和 @SpaceXAI 团队,我会非常感激。我很希望他们能看到这篇文章,也想为他们做出这个产品说声谢谢。
另外向 @X 团队提一个请求——请再复核一次我的变现申诉。你们暂停了它,但这里的每一份内容都是我的:我自己的研究、我自己的经验、我自己的写作。我把 X 当作一份真正的工作来对待。
感谢每一位提供帮助和支持的人。
此致,@adiix_official