Warp 如何基于 Claude 构建自我改进的 Agent
了解 Warp 如何设计出一套任何人都能用来创建自我改进 Agent 的简单开发模式。
在我们的系列文章中,我们重点关注初创公司如何利用 AI 变革自己的行业。在这篇文章中,我们分享 Warp 如何把无状态的用户反馈转化为其 Agent 的自我改进循环。
速览
| 项目 | 内容 |
|---|---|
| 名称 | Warp |
| 成立年份 | 2020 年 |
| 创始人 | Zach Lloyd(CEO) |
| 技术栈 | Rust、Golang、GitHub Actions、内部 agent 编排平台(Oz)、Claude Platform |
| 增长 | 累计融资 7300 万美元;每月 80 万开发者在其上构建;56% 的财富 500 强企业使用 Warp;Warp 内迄今已运行 1000 万次 Claude Code 会话(每周超 40 万次);Warp Agent 对话累计 4000 万次 |
Agent 需要可靠且高效地处理重复出现的任务。一个首次运行只能完成 80% 任务的 prompt,会给用户带来嘈杂而恼人的体验。Warp 对此深有体会,并据此调整了产品策略,为全球近 100 万开发者打造了更好的体验。
Warp 是一款 AI 驱动的终端和 agentic 开发环境,构建在 Claude Platform 之上。该团队在内部代码评审 Agent 上就遇到了这种“嘈杂体验”问题。工程师们抱怨他们的 Agent 给出的评论毫无帮助、产出质量低下。
团队最初尝试过一些权宜之计,比如根据观察到的代码评审失败案例手动重写 prompt。这确实让输出更可用,但无法规模化。改进 AGENTS.md 之类的上下文文件也有帮助,但远算不上彻底的解决方案。
最终他们意识到,真正的问题在于:无论 Agent 的用途是什么,给它的反馈通常在会话结束时就消失了,关键的上下文随之脱离了 agentic 循环。他们的解决方案:一个基于 Agent Skills 的框架,用来创建自我改进的 Agent——反馈随时间不断复利累积,持续打磨并增强 Agent 的输出。
请继续阅读,了解他们如何在 Claude Platform 之上用 skill 实现这一机制。
基于 skill 的 Agent 自我改进循环
核心技术是用 skill 构建自我改进循环。skill 是一种以文件形式编码的知识,把指令从原始 prompt 中剥离出来。Warp 逐步演化出一种由两个 skill 组成的自我改进 Agent 架构,中间夹着人类反馈。
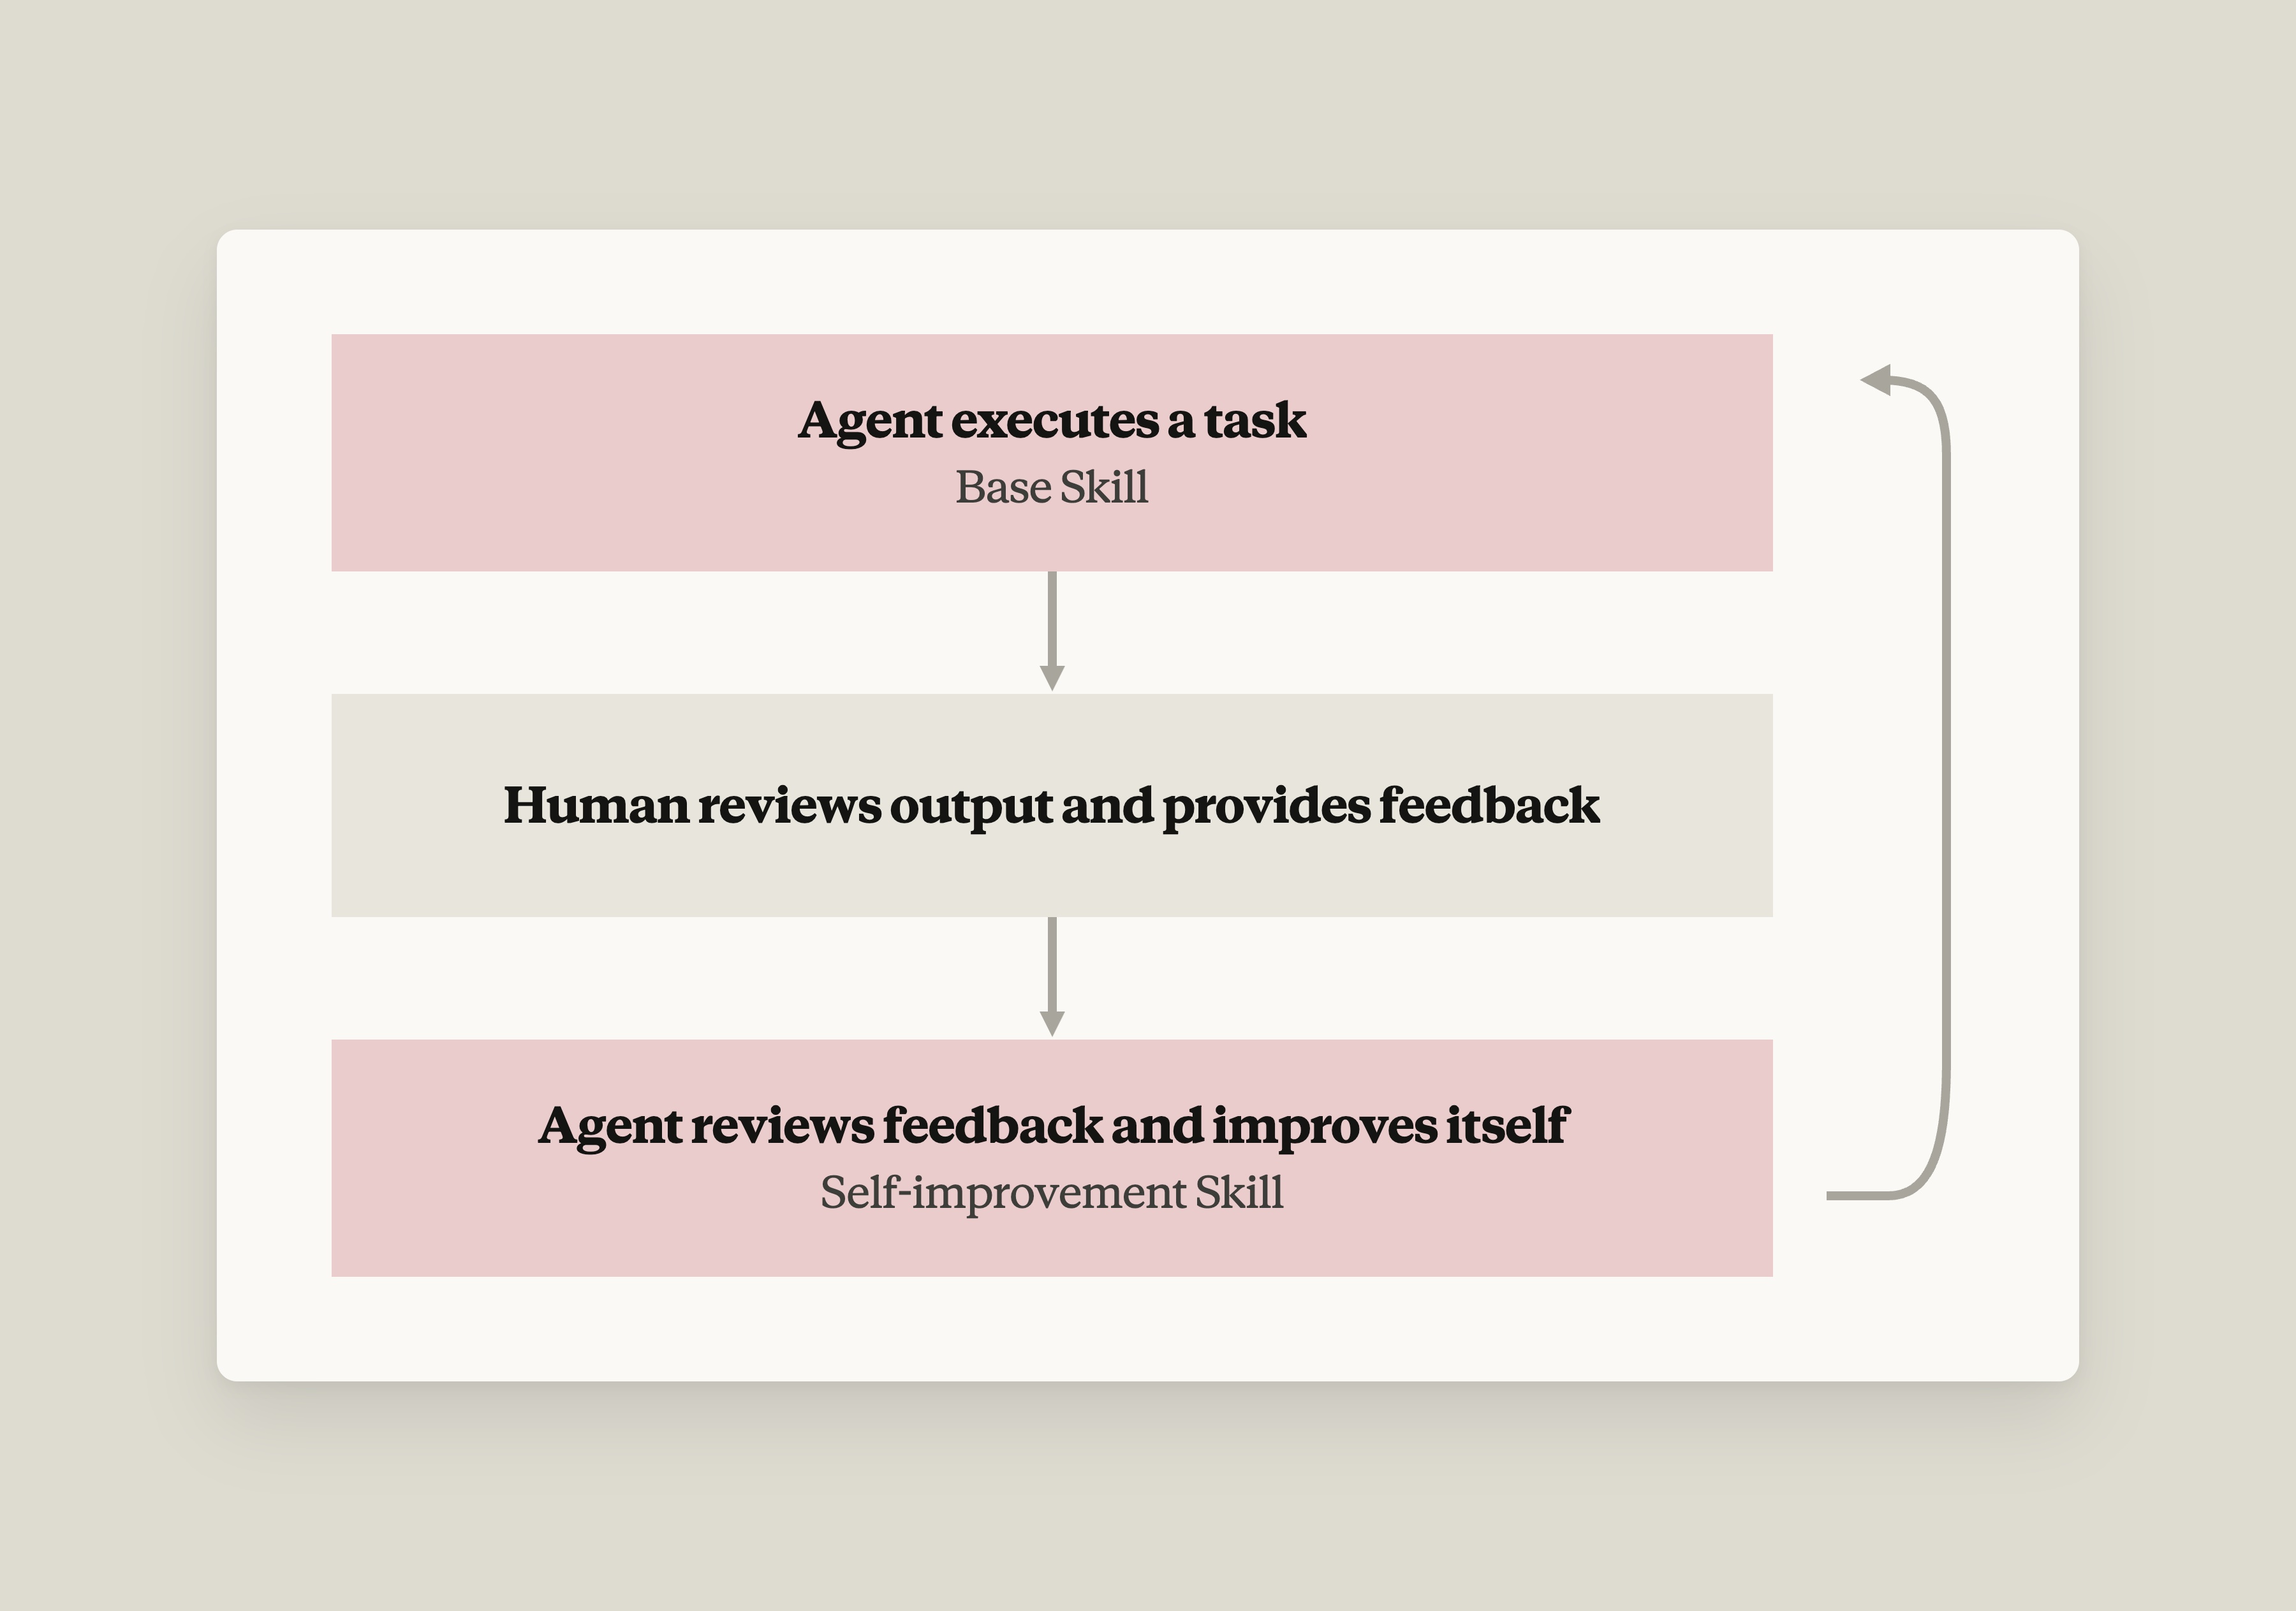
内层/基础 skill(inner/base skill)承载功能性的领域知识与指令。例如,当一个 PR 被打开时,Warp 的代码 Agent 会基于这个基础 skill 和上下文执行,产出评审结果。
针对 Agent 输出的人类反馈是自我改进循环的关键组成部分。对代码评审来说,反馈可以简单到一个点赞(thumbs up),但越明确越好。
“人类可以表示认可,‘这条评论不错,有用’,”Warp 创始人 Zach Lloyd 解释道,“但人类也可以详细说明为什么一次代码评审做得不好。诸如‘你建议重命名这个变量,但我们的代码库约定是:这类全局变量使用这种特定命名上下文’的具体反馈,能告诉 Agent 下次如何做对。”
外层/改进 skill(outer/improver skill)扮演观察者 Agent 的角色,按计划定期运行,而不是每个任务跑一次。它汇总累积的人类反馈,把 Agent 的建议与人类的实际反应进行对比,然后对基础 skill 提出一处小而聚焦的修改。
由于 skill 就是普通文件,Agent 更新起来得心应手。这些更新可评审、可批准、可合并,能够走正常的 PR/代码评审工作流;一旦合并,内层 skill 的下一次运行就会继承这一改进。
Warp 现在在整个开源仓库中运行这一模式:规格编写(spec-writing)、评审(review)和分诊(triage)三类 Agent 各司其职,每个都带有自己的自我改进循环。
“基于文件的 skill 是一种为 Agent 编码知识的方式,不必把知识直接塞进 prompt,Agent 在工作过程中随时可以查阅,”Zach 说,“这个框架其实非常简单:一个基础领域 skill,再加一个用来打磨这个领域 skill 的 improver skill。简单正是这种方法的美妙之处。”
如何为 Agent 编写自我改进的 skill
以下是 Warp 团队在为 agentic 循环编写自我改进 skill 时总结的若干行之有效的建议:
- 写原则,而非规则。 “构建 skill 时,要像在指导一个聪明人,而不是在给计算机编程,”Zach 说,“在 skill 中写上‘寻找重复代码’这样的方向性指引,比罗列详尽的变量命名规则更有效。”
- 解释为什么。 给出规则背后的理由,让 Agent 能够对问题进行推理,而不是死板地执行指令,同样有助于更好的泛化。
- 让反馈的给出毫不费力。 在人们已经工作的地方捕获反馈,比如直接在 PR 或 issue 上评论。同时让这一过程自动发生,不需要额外的提交步骤。“低摩擦才能让信号持续流动,”Zach 指出,“如果反馈太难给出,你既拿不到反馈,也无法改进 skill。”
- 保持 skill 精简,使用渐进式披露。 一个好的 skill 文件并不大;它通过引用资源文件和脚本来按需加载,而不是把所有内容一次性塞进上下文。
- 反馈质量 > 数量,但数量也有帮助。 来自资深工程师的少量详尽、贴合领域的反馈,可能比大量粗略反馈更有价值,因为简单的点赞/点踩说不出为什么。“即使样本量相对较小,只要是一个人就特定领域知识给出的非常详尽的反馈——这些知识本来是 Agent 无从获取的——你也能获得非常好的信号,”Zach 继续说道,“话虽如此,高质量信号的语料库越大越好。在 Warp,我们用一个循环来管理整个开源仓库。我们有数百人参与贡献,代码评审数以千计。”
- 在 improver skill 上多花功夫。 为 improver skill(观察者 Agent)的编写多投入精力,其回报会超出当前的 Agent 循环,因为 improver skill 在不同用例之间高度可复用。“抛开领域知识部分,这是一个相当可复用的机制——代码评审 Agent 的 improver skill 与任何其他 Agent 的 improver skill 并没有太大区别。”
循环实战:Warp 的 issue 分诊 Agent
Warp 的 issue 分诊 Agent 展示了自我改进 Agent skill 框架。每当有人提交新的 GitHub issue 时,这一模式就会被触发:一个 GitHub Action 启动一个 Agent,分析该 issue 的复杂度与可行性,打上标签,并为修复方向提出建议。这个分诊 Agent 运行时依赖一个内层 skill 文件,其中保存着关于每个标签含义、以及在行动前如何调研代码库的领域知识。
在一个示例 issue 上,第一阶段的内层 skill 表现扎实,但漏掉了一个标签:ready to spec——它表示贡献者可以开始基于该 issue 编写产品与技术规格了。Warp 团队的一位维护者发现了这个疏漏,直接在 issue 上留下了反馈,正是在工作发生的地方。关键是,他既说明了自己期望什么,也解释了为什么这样期望:这样的反馈具体可行,便于 Agent 日后吸收。
外层 improver skill 运行在 Oz——Warp 的 Agent 编排平台中,作为一个定时运行的“update triage”Agent。该 Agent 完成 GitHub 认证后,运行 skill 自带的一个 Python 脚本,拉取近期带有反馈的 issue,将其汇总为一个 JSON 文件,再读回上下文。脚本随 skill 打包本身就是一项最佳实践;skill 可以引用资源文件,而不必每次运行都重新写代码。
在此基础上,该 Agent 从维护者的评论中识别出具体的反馈信号,并提出了能涵盖这些信号的最小修改。它开了一个 PR,编辑内层 skill:当 issue 描述了一个真实问题、即便具体的 UI 或 UX 形态尚未确定时,就打上“ready to spec”标签。
由于整个更新就是一个 skill 文件,它走的是正常的代码评审工作流。这个 PR 附带说明,解释了哪些信号促成了此次修改、修改了什么。由人类评审、批准并合并,分诊 skill 的下一次运行便继承了新知识。最后这道人工环节闭合了循环,也让实际改动了什么始终处于人的掌控之中。
这正是 Warp 如今在其开源仓库上大规模运行的同一机制:规格编写 Agent、评审 Agent 和分诊 Agent 各自携带自己的自我改进循环。
任何 Agent,无论其任务是什么,只要从一开始就内建这样一个循环——捕获人类反馈信号、将其转化为 skill 更新——都能随时间越变越好,让 Agent 从一次性的帮手成长为在整个组织中不断复利的强大系统。
Warp 团队的最佳实践
| 问题 | 要点 |
|---|---|
| 你是否把 skill 和记忆混为一谈? | skill 是程序性且稳定的——“如何做 X”,与运行方式无关、只在审慎修改时才变化。记忆则是 agent 在推理时自动写入、从不停止变化的。 |
| 需要一个改进循环,还是每个 agent 一个? | 折中:用一个模板化的基础循环捕获各 agent 之间的共性,再叠加领域专属权重。improver 只有几个时可以各管一个;上百个就该共享。 |
| 反馈错了怎么办? | 假定它总会出错。不要让 agent 盲目接受反馈——给它做甄别核实的上下文,过滤哪些人的输入算数,并在过滤或终审环节保留人工把关。 |
| 你的领域可验证吗? | 先搭建验证装置,再让 agent 针对它调优:生成参考语料、对比输出与参考、修复、循环往复。 |
| 领域不可验证怎么办? | 凡是有黄金标准输出之处,尽量做确定性评测;必须依赖人类反馈时,把它限定在领域专家范围内——不要敞开大门。 |
| 怎么知道整个系统在变好? | 跟踪人类本来就在盯的全局指标——合并时长、贡献者数量、成本——并把它们回馈给 improver agent。部署节奏上循序渐进(crawl-walk-run)。 |
观看完整 webinar,了解现场演示,并深入探讨 Warp 如何用 Claude 构建能从团队反馈中学习、随时间不断自我改进的 Agent。